Scikit-learn 是什么:先看局限再看定位
很多用户搜索“Scikit-learn 能做深度学习吗”或“Scikit-learn 支持 GPU 吗”。答案是否定的。这个工具不支持深度学习,也不支持 GPU 加速。它只做传统机器学习。
不支持深度学习的边界
Scikit-learn 对多层感知机(MLP,一种基础神经网络)支持有限。0.18 版本之后才加入 MLP 实现。它不适合大规模神经网络任务。图像识别、自然语言处理、语音识别等场景,需要 TensorFlow 或 PyTorch。
该工具从未把深度学习作为目标。官方文档明确列出神经网络模型,但标注为“有监督”和“无监督”两类。实现简单,参数少。训练深层网络会非常慢。
面向传统机器学习的定位
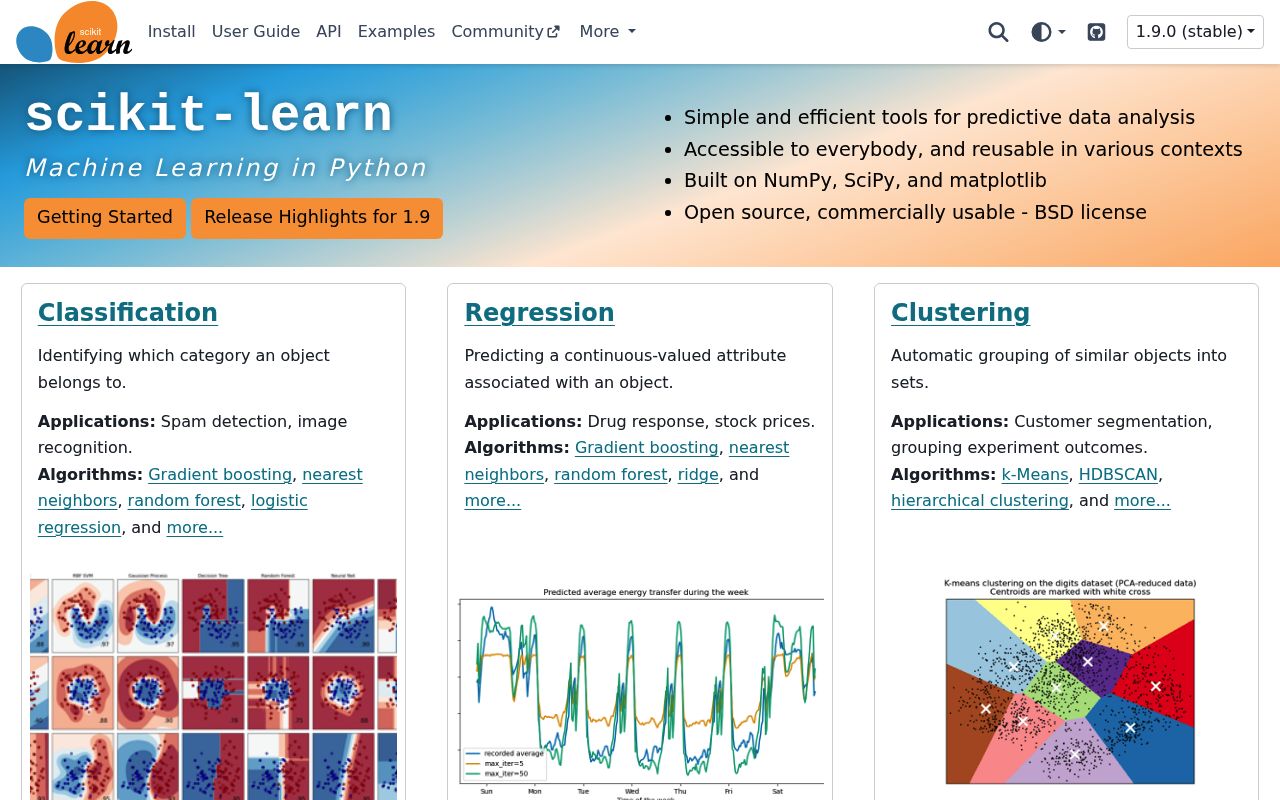
Scikit-learn 是 Python 开源机器学习库。它构建在 NumPy、SciPy、matplotlib 之上。该工具提供分类、回归、聚类、降维等算法。定位是数据挖掘和数据分析工具。
它遵循 BSD 许可证,可商用。API 设计一致。适合表格数据、中小规模数据集。不适合图像、音频、文本等非结构化数据。
Scikit-learn 功能列表:六大模块拆解
该工具的功能分为六个模块。每个模块解决一类问题。
- 算法:分类、回归、聚类、降维
- 预处理:特征缩放、缺失值处理、特征编码、特征选择
- 模型选择:交叉验证、超参数调优、性能评估
- 流水线:Pipeline 串联数据预处理、模型训练、评估
- 集成学习:Bagging、Boosting、随机森林
- 多输出:多输出分类、多输出回归、多标签分类
分类与回归算法
分类算法覆盖逻辑回归、支持向量机(SVM)、随机森林、决策树、K 近邻、朴素贝叶斯。回归算法覆盖线性回归、岭回归、Lasso、支持向量回归、梯度提升回归。
每个算法都有统一的 fit 和 predict 方法。切换模型只需改一行代码。
聚类与降维算法
聚类算法覆盖 KMeans、DBSCAN、层次聚类、高斯混合模型。降维算法覆盖主成分分析(PCA)、线性判别分析(LDA)、流形学习。
KMeans 适合发现球形分组。DBSCAN 适合发现任意形状分组。PCA 用于可视化高维数据。LDA 是有监督降维。
数据预处理与模型选择
预处理包括 StandardScaler、MinMaxScaler、OneHotEncoder、SimpleImputer。模型选择包括 train_test_split、cross_val_score、GridSearchCV。
StandardScaler 将特征缩放到均值 0 方差 1。MinMaxScaler 缩放到 0 到 1 区间。SimpleImputer 填充缺失值。GridSearchCV 穷举参数组合。
流水线与集成学习
Pipeline 将多个步骤串联。例如先标准化,再训练逻辑回归。集成学习包括 Bagging、Boosting、随机森林。
随机森林是 Bagging 的代表。梯度提升是 Boosting 的代表。这些方法通常比单个模型更稳定。
Scikit-learn 使用方法:从安装到模型持久化
使用该工具需要五个步骤。安装、导入、划分数据、训练、评估、保存。
安装与导入
pip install -U scikit-learn
或
conda install -c conda-forge scikit-learn
导入常用模块:
import numpy as np
import pandas as pd
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
数据划分与模型训练
加载内置数据集:
iris = datasets.load_iris()
X = iris.data
y = iris.target
划分训练集和测试集:
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
标准化并训练:
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

model = LogisticRegression()
model.fit(X_train, y_train)
模型评估与保存
评估准确率:
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Accuracy: {accuracy:.2f}')
交叉验证:
from sklearn.model_selection import cross_val_score
scores = cross_val_score(model, X, y, cv=5)
保存和加载模型:
import joblib
joblib.dump(model, 'model.pkl')
model = joblib.load('model.pkl')
Scikit-learn 对比主流替代品:差异与选择
该工具与 TensorFlow、PyTorch、XGBoost 定位不同。选择取决于任务类型。
与 TensorFlow/PyTorch 的边界
TensorFlow 和 PyTorch 专注深度学习。它们支持 GPU 加速、自动微分、动态计算图。Scikit-learn 不做这些。
如果任务是图像分类、文本生成、语音识别,应该用 TensorFlow 或 PyTorch。如果任务是表格数据分类、回归、聚类,该工具更合适。
与 XGBoost 的侧重
XGBoost 专注梯度提升树。它在结构化数据上表现极强。Scikit-learn 提供更广的算法面。
XGBoost 有 GPU 支持、早停、缺失值自动处理。该工具的 GradientBoostingClassifier 功能较少。但该工具还有 SVM、KMeans、PCA 等 XGBoost 没有的算法。
| 特性维度 | 主要任务 | GPU 支持 | 算法广度 | 表格数据 | 图像/文本 |
|---|---|---|---|---|---|
| Scikit-learn | 传统机器学习 | 无 | 广 | 好 | 不适合 |
| TensorFlow/PyTorch | 深度学习 | 有 | 窄(神经网络) | 一般 | 适合 |
| XGBoost | 梯度提升树 | 有 | 窄(树模型) | 极好 | 不适合 |
Scikit-learn 用户实际体验:五个典型场景
用户主要用该工具做五类任务。数据挖掘、数据分析、分类、回归、聚类。
- 数据挖掘:从大量数据中提取信息
- 数据分析:探索性分析,可视化高维数据
- 分类:垃圾邮件检测、疾病诊断
- 回归:房价预测、销量预测
- 聚类:发现数据中的自然分组
数据挖掘与探索性分析
聚类算法发现数据中的自然分组。例如 KMeans 对客户分群。PCA 将高维数据降到 2 维或 3 维。然后可视化。
这些是探索性分析常用手段。不需要标签。适合初步理解数据结构。
分类与回归任务
分类任务包括垃圾邮件检测、疾病诊断、图像分类(小规模)。回归任务包括房价预测、股票价格预测、销售量预测。
该工具提供多种算法。用户可以快速对比逻辑回归、随机森林、SVM 的效果。
Scikit-learn 用户价值:具体收益与局限并存
该工具易用、集成度高、文档好。但灵活性有限。算法是黑盒。
易用性与生态集成
API 一致。所有模型都有 fit、predict、score 方法。与 Pandas、NumPy 无缝配合。数据可以轻松在 DataFrame 和数组间转换。
官方文档详尽。每个算法有理论说明和代码示例。社区活跃。遇到问题容易找到答案。
灵活性与定制限制
算法以黑盒形式提供。用户无法修改内部工作原理。例如不能自定义损失函数。不能添加自定义层。
对于需要高度定制的场景,该工具不够灵活。此时应该用 TensorFlow 或 PyTorch。
Scikit-learn 最近更新带来的变化:1.0 版本的强制约束
1.0 版本引入了两个重大变化。强制关键词参数。强制特征名称对齐。
predict 方法的关键词参数强制
从 1.0 版本开始,SVC、LogisticRegression 等模型的 predict 方法不再接受位置参数。必须写 model.predict(X=X)。
旧版 model.predict(X) 能跑通。1.0 会抛 TypeError。原因是方法签名改成了 predict(*, X)。星号后的参数必须用关键词传。
特征名称对齐校验
训练时用 DataFrame,预测时用 ndarray,1.0 会抛 ValueError。旧版 0.24 可能静默通过。
1.0 新增 model.feature_names_in_ 属性。记录训练列名。预测时会检查列名和顺序。不一致就报错。
Scikit-learn 底层模型技术栈:构建在三大库之上
该工具依赖 NumPy、SciPy、matplotlib。底层用 Cython 优化。
依赖库与性能优化
NumPy 提供数组运算。SciPy 提供科学计算。matplotlib 提供可视化。Cython 将部分代码编译成 C。提升执行效率。
这些依赖让该工具能处理中等规模数据。但不能分布式训练。不能 GPU 加速。