Open LLM Leaderboard 是什么:定位和人群
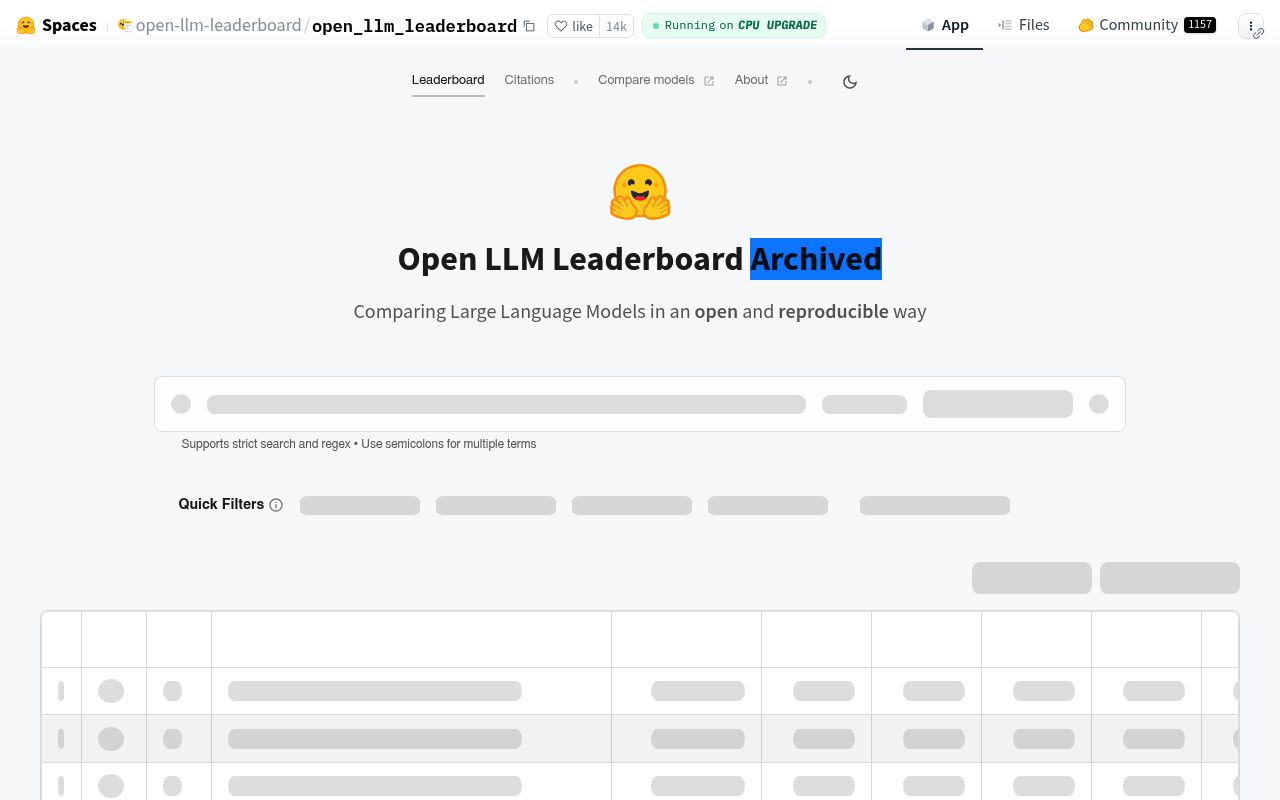
Open LLM Leaderboard 是 Hugging Face 推出的开源大模型排行榜。它基于 EleutherAI 的评估框架封装,对各类大型语言模型进行多维度基准评估。该平台提供实时更新的动态排名,帮助用户横向对比模型性能。
基于 EleutherAI 评估框架的架构
排行榜底层使用 EleutherAI Language Model Evaluation Harness(语言模型评估框架)。该框架封装了多个基准测试任务,统一了评估流程。根据官方文档,它支持预训练模型、聊天模型等多种类型。评估结果以数值形式展示,并附有模型输入输出细节。
面向开发者和研究人员的定位
该平台主要服务模型开发者、研究人员和需要选型的工程师。开发者可以用它作为基准对标工具,明确模型在行业中的位置。研究人员能借助统一平台验证新模型是否达到行业标准。工程师则根据多维度得分筛选适合特定任务的模型。
Open LLM Leaderboard 主要功能的实际表现
该平台的核心功能围绕多维度评估展开。它综合多项基准测试得分,生成模型能力图谱。排行榜数据随新模型提交而动态刷新。社区成员可对模型进行标记和讨论,提升透明度。
六大基准测试的技术定义
- IFEval:评估模型遵循明确指令的能力,如格式要求,使用严格准确率指标。
- BBH(BIG-Bench Hard):包含 23 个高难度子任务,涵盖多步算术、算法推理和语言理解。
- MATH:测试模型解决高中竞赛级别数学问题的能力,要求严格遵循特定输出格式。
- GPQA(Graduate-Level Google-Proof Q&A Benchmark):由专家设计的高难度知识问答任务,涵盖多领域专业知识。
- MuSR(Multistep Soft Reasoning):用复杂多步推理问题,如谋杀案谜题,评估模型的长距离上下文解析和推理能力。
- MMLU-PRO(Massive Multitask Language Understanding – Professional):改进版的多任务语言理解评估,增加选择数量,提高问题难度,减少噪声。
支持模型类型与结果展示
排行榜支持预训练模型、持续预训练模型、领域特定微调模型和聊天模型。每种类型覆盖不同应用场景。结果展示包含详细的数值得分和模型输入输出细节。用户点击模型名称即可查看完整性能数据。
社区标记与可复现性工具
社区成员可以对模型进行标记和讨论。该机制确保排行榜的公正性和透明度。平台提供代码和工具,帮助用户复现排行榜上的结果。复现工具基于 lm-evaluation-harness,支持命令行操作。
Open LLM Leaderboard 操作步骤
从访问页面到复现评估结果,完整流程包括四步。首先打开排行榜页面查看当前排名。然后点击模型名称查看详情。接着用筛选功能对比模型。最后用代码工具复现结果。
访问排行榜与查看模型详情
- 打开 Open LLM Leaderboard 页面。
- 查看当前模型排名和性能数据。
- 点击感兴趣的模型名称。
- 查看该模型的详细性能数据。
筛选和比较模型
- 使用页面提供的筛选功能。
- 根据模型类型、性能指标等条件筛选。
- 对比不同模型在各基准测试中的表现。
- 选择最适合需求的模型。
用 lm-evaluation-harness 复现结果
git clone git@github.com:huggingface/lm-evaluation-harness.git
cd lm-evaluation-harness
git checkout main
pip install -e .
lm-eval --model_args="pretrained=,revision=,dtype=" --tasks=leaderboard --batch_size=auto --output_path=
替换 pretrained=、revision=、dtype= 和 output_path 为实际值。对于指令模型,添加 --apply_chat_template 和 --fewshot_as_multiturn 选项。
Open LLM Leaderboard 和同类差在哪
Open LLM Leaderboard 与 OpenRouter LLM Rankings、MT-Bench 存在明显差异。前者基于基准测试得分,后者分别基于 Token 使用量和多轮对话。三种评测方式各有侧重。
与 OpenRouter LLM Rankings 的指标差异
OpenRouter LLM Rankings 的核心指标是 Token 使用量。它反映模型在真实世界应用中的受欢迎程度。Open LLM Leaderboard 则基于基准测试得分。两者衡量维度不同,前者关注市场使用,后者关注学术能力。
与 MT-Bench 的评估维度差异
MT-Bench 由 80 个高质量多轮对话问题组成,侧重多轮对话和指令遵循能力。Open LLM Leaderboard 覆盖更广的推理与知识任务。后者包含数学、专业知识问答等维度,评估范围更全面。
Open LLM Leaderboard 适用场景与人群
- 模型评估与选型:开发者快速筛选适合智能客服、内容生成等任务、综合得分更靠前的开源模型。
- 学术研究:为学术界提供统一的基准测试平台,推动语言模型技术发展。
- 社区互动:鼓励开发者提交模型到排行榜,分享研究成果。
- 教育学习:帮助学生和初学者了解语言模型的评估方法和性能指标。
- 技术验证:验证新开发的语言模型是否达到行业标准,与其他模型对比发现优势和不足。
模型评估与选型
开发者可以用该平台快速筛选适合特定任务的开源模型。例如,智能客服场景需要模型具备较强的指令遵循能力。内容生成场景则更看重推理和知识广度。排行榜的多维度得分帮助开发者做出选择。
学术研究与技术验证
学术界使用该平台作为统一基准测试平台。研究人员可以评估新模型的性能,并与已有模型对比。该平台帮助验证新模型是否达到行业标准。它也为模型优化提供了参考依据。
社区互动与教育学习
排行榜鼓励开发者提交模型,分享研究成果。社区成员可以讨论模型表现,形成同行评审氛围。对于初学者,该平台是了解评估方法的实践工具。学生可以通过查看模型得分学习评估指标。
Open LLM Leaderboard 用户受益点
用户通过该平台可以快速定位性能领先的开源模型。多维度评估避免了单一分数的局限。公开透明的排行榜促进了模型优化与技术演进。
筛选当前最先进模型
排行榜通过多维度评估帮助用户快速定位性能领先的开源模型。用户可以根据特定任务需求筛选模型。例如,数学任务可以重点关注 MATH 得分。指令遵循任务则参考 IFEval 得分。
推动开源社区进步
公开透明的排行榜促进模型优化与技术演进。开发者可以看到自己模型在行业中的位置。这激励他们改进模型性能。社区讨论和标记机制也提升了评估的公正性。
Open LLM Leaderboard 近期版本与功能变化
根据 GitHub 公开信息,lm-evaluation-harness 新增了 Open LLM Leaderboard 任务组。该任务组包含 Winogrande、GSM8k、DROP 等基准测试。这些新增任务扩展了排行榜的评估范围。
新增基准测试与任务组
lm-evaluation-harness 新增 Open LLM Leaderboard 任务组。该任务组包含 Winogrande、GSM8k、DROP 等基准测试。这些任务使用 EleutherAI 框架中的原始实现。新增任务进一步丰富了排行榜的评估维度。
Open LLM Leaderboard 总体评价
Open LLM Leaderboard 提供了多维度、可复现的开源模型评估。它的优势在于评估范围广、结果透明。固定基准也可能带来一定局限。
技术优势与局限
该平台的优势包括多维度评估、可复现性支持和社区互动。它避免了单一分数局限,增强了研究的可信度。局限在于固定基准可能无法覆盖所有应用场景。部分模型可能在特定任务上表现优异,但在排行榜上得分不高。
Open LLM Leaderboard 价格档位
Open LLM Leaderboard 完全免费。没有付费版或隐性费用。排行榜页面和复现工具均免费开放。
免费使用与无隐性费用
排行榜页面和复现工具均免费开放。无订阅或 API 调用费用。用户可以直接访问页面查看所有模型得分。复现工具 lm-evaluation-harness 也是开源免费的。
Open LLM Leaderboard 性价比分析
与商业评测服务相比,该平台免费提供多维度基准测试结果。这降低了模型选型的成本。对于个人开发者和小团队,零成本获取选型依据具有较高价值。
零成本获取模型选型依据
商业评测服务通常需要付费订阅。Open LLM Leaderboard 免费提供多维度基准测试结果。用户无需支付任何费用即可获取模型选型依据。这降低了模型选型的成本,尤其适合预算有限的团队。
Open LLM Leaderboard 数据隐私与安全
排行榜仅展示模型评估结果。它不收集用户个人数据。用户访问页面时无需注册或登录。
公开数据与无用户数据收集
排行榜仅展示模型评估结果。它不收集用户个人数据。用户访问页面时无需注册或登录。所有数据都是公开的模型性能得分。
Open LLM Leaderboard 学习曲线
页面操作直观,复现工具提供命令行说明。开发者可以在数小时内掌握基本用法。文档质量较高,提供了详细的命令示例。
低上手门槛与文档支持
页面操作直观,用户可以直接查看排名和模型详情。复现工具提供命令行说明,文档包含完整命令示例。开发者可以在数小时内掌握基本用法。对于非技术用户,页面浏览无需任何技术背景。