LangGPT 是什么:结构化提示词的编程语言
LangGPT 是 GitHub 上开源的一种结构化提示词设计方法,定位为「面向大语言模型的编程语言」。注册或克隆项目后,用户会先看到 README 中的模板示例,例如 FitnessGPT 角色定义。该框架借鉴编程语言中的类与对象结构,将提示词分为模板和实例两层。模板定义角色、规则、工作流等固定结构,实例则填入具体内容。这种设计让提示词编写从自由文本变为填空式操作。
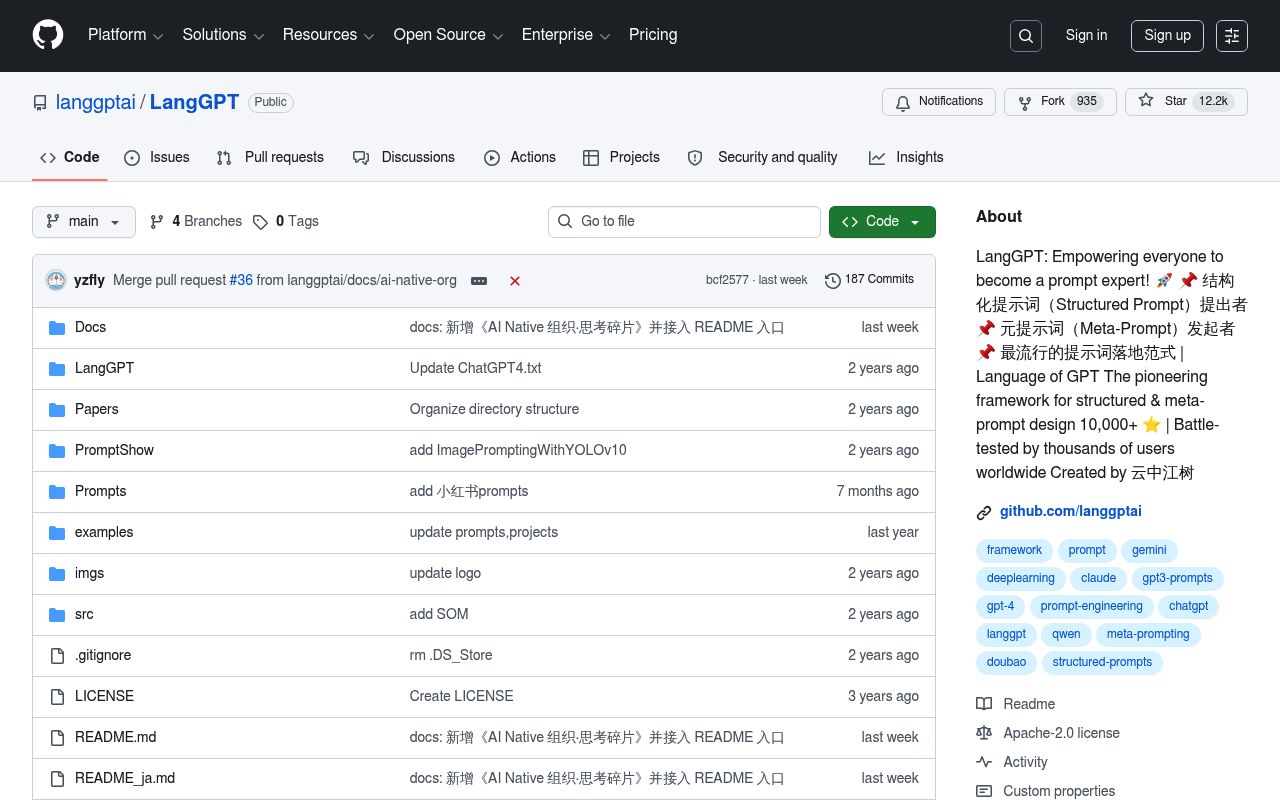
根据 SegmentFault 思否 2023 年 5 月的介绍,LangGPT 为大规模生产高质量 prompt 提供了可能。它强调系统性、灵活性和交互友好性。项目在 GitHub 上开源,曾进入全球趋势热榜前十。社区用户可提交模板或修改文档,推动提示词共享。
双层框架:类与对象如何映射到 Prompt
LangGPT 的双层结构直接类比面向对象编程。模板相当于类,定义了角色属性、规则、工作流等字段。实例相当于对象,是填入具体参数后的可执行提示词。例如,一个「诗人」模板包含角色描述、技能、约束等模块。用户填写姓名、风格、输出格式后,就得到一个具体诗人实例。
这种映射降低了学习成本。用户不需要理解底层模型机制,只需按字段填写。模板可复用,同一模板能生成多个不同实例。官方文档指出,该设计让提示词编写「像面向对象编程一样直观」。
模板、变量、命令:三个核心语法元素
LangGPT 定义了三个核心语法元素:模板、变量、命令。模板提供结构化骨架,例如 Role、Profile、Rules、Workflow 等模块。变量用尖括号标记,如 <VariableName>,代表动态内容。命令用于执行预定义行为,例如切换语言或重置对话。
变量是 LangGPT 区别于传统提示词技巧的关键。用户可以在模板中设置变量,然后在引用时修改。例如,FitnessGPT 模板中定义
#Age、#Gender、#Height变量。用户输入具体数值后,模型按变量位置生成定制方案。命令则让提示词具备可编程性,例如设置中英文切换。
开源与社区:GitHub 趋势榜前十的项目
LangGPT 项目完全开源,托管在 GitHub。根据公开数据,它曾进入 GitHub 全球趋势热榜前十。仓库包含 Docs、examples、templates 等目录。用户可提交 issue 或 pull request 参与改进。
社区贡献体现在多个方面。有人提交韩语翻译,有人修复移动端问题,有人添加自定义采样参数。GitHub 提交记录显示,贡献者包括 quzard、idawnwon、Kamilake 等。这种开放模式加速了框架迭代。
LangGPT 功能和实际使用:从模板到 Reminder
LangGPT 的功能围绕模板、变量、工作流和 Reminder 展开。模板让用户按固定结构填写,变量实现动态内容引用,工作流定义交互步骤,Reminder 缓解长期记忆缺失。这些功能共同降低提示词编写门槛。
根据 SegmentFault 思否的总结,LangGPT 有五个优点:系统性、灵活性、可编程性、交互友好性、模块化配置。其中 Reminder 功能专门解决对话过长时模型遗忘早期指令的问题。
系统性模板:填鸭式编写降低门槛
模板是 LangGPT 的核心。用户不需要从零设计提示词,只需选择合适模板并填空。例如,角色模板包含 Author、Version、Language、Description 等字段。用户填写后,模型就能按角色设定响应。
这种填鸭式编写降低了学习成本。传统提示词技巧依赖经验和试错,而模板提供了明确结构。官方示例 FitnessGPT 展示了完整流程:定义角色、列出规则、创建工作流。用户照抄格式即可。
变量引用:像编程一样修改 Prompt 内容
变量让提示词内容可动态修改。LangGPT 使用尖括号标记变量,例如 <VariableName>。用户可以在模板中声明变量,然后在引用时赋值。这种方式类似于编程中的参数传递。
例如,一个翻译模板可以定义 <SourceLanguage> 和 <TargetLanguage> 变量。用户使用时只需修改这两个值,无需重写整个提示词。官方文档指出,变量简化了角色内容引用和属性修改。
工作流与 Reminder:定义交互并缓解记忆缺失
工作流定义角色与用户的交互步骤。例如,FitnessGPT 的工作流包括:接收用户信息、询问目标、生成计划、确认调整。用户按步骤操作,模型按流程响应。
Reminder 用于缓解长期记忆缺失。当对话过长时,模型可能遗忘早期指令。Reminder 在提示词中重复关键约束,例如「始终以 JSON 格式输出」。这能保持对话连贯性。
LangGPT 怎么用:从选模板到测试调整
使用 LangGPT 的流程分为八步:理解核心概念、选择模板、填写内容、使用变量、定义工作流、初始化角色、测试调整、使用助手。注册后通常会看到 README 中的快速启动示例。
用户首先需要熟悉 Markdown 语法。官方文档建议使用 GPT-4 或 Claude 作为底层模型。然后从 templates 目录选择合适模板,按字段填写。
理解核心概念:模板、变量、工作流
使用前必须掌握三个概念。模板是结构化骨架,变量是动态内容标记,工作流是交互步骤定义。三者共同构成 LangGPT 提示词。
模板提供字段结构,例如 Role、Profile、Rules。变量用尖括号标记,例如 <Age>。工作流用编号列表定义,例如「1. 接收输入 2. 生成输出」。理解这三个概念后,用户就能上手编写。
选择并填写模板:以角色模板为例
选择模板取决于任务类型。例如,想要模型扮演诗人,就选诗人角色模板。模板通常包含角色描述、技能、规则、工作流等字段。
以 FitnessGPT 为例,用户填写 Author、Version、Language、Description。然后在 Rules 中列出约束,例如「不要打破角色设定」。最后在 Workflow 中定义步骤。填写完成后,提示词即可使用。
定义工作流与初始化角色
工作流是角色与用户的交互步骤。例如,客服角色工作流包括:问候用户、询问问题、提供解决方案、确认满意度。用户按步骤响应,模型按流程执行。
初始化角色是可选步骤。它在交互开始前执行,例如让模型先自我介绍。官方文档提到,初始化行为可以在角色开始与用户交互前设置。这能让对话更自然。
测试、调整与使用 LangGPT 助手
编写完成后,将提示词输入大语言模型测试。根据输出调整字段内容或工作流步骤。例如,如果模型输出偏离角色设定,就修改 Rules 中的约束。
LangGPT 助手可以辅助生成模板。用户描述需求,助手输出相应提示词模板。这进一步降低了编写门槛。测试和调整是迭代过程,通常需要多轮。
LangGPT 与主流工具对比:结构化 vs 自由式
LangGPT 与传统提示词技巧、CRISPE 等结构化方法、通用提示词库存在明显差异。核心区别在于系统性和可复用性。传统技巧依赖经验,CRISPE 模块化程度较低,提示词库只是静态收藏。
以下表格对比三个维度:
| 特性维度 | 结构化程度 | 可复用性 | 交互定义 |
|---|---|---|---|
| LangGPT | 高(双层框架) | 高(模板+变量) | 支持工作流 |
| 传统提示词技巧 | 低(自由文本) | 低(每次重写) | 不支持 |
| CRISPE | 中(单层框架) | 中(固定模块) | 不支持 |
对比传统提示词技巧:系统性与可复用性
传统提示词技巧提供原则和建议,例如「明确指令」「提供示例」。但缺乏系统性,用户需要自己组织内容。同一任务每次都要重写提示词,适应性差。
LangGPT 通过模板和变量解决这个问题。模板提供固定结构,变量实现内容复用。用户只需修改变量值,就能生成新提示词。官方文档指出,传统方法「缺乏系统性和适应性」。
对比 CRISPE 等结构化方法:模块化程度差异
CRISPE 是另一种结构化提示词方法,包含 Capacity、Role、Insight、Statement、Personality、Experiment 六个模块。但它只有单层结构,模块固定,无法扩展。
LangGPT 采用双层结构,支持扩展模块。用户可以根据需求添加新模块。这种设计提高了灵活性。例如,用户可以添加「输出格式」模块,而 CRISPE 没有对应字段。
对比通用提示词库:从静态收藏到动态生成
通用提示词库是静态收藏,用户从中挑选现成提示词。但库中提示词无法调整,遇到新任务就失效。用户只能继续收藏,不能生成。
LangGPT 提供生成框架。用户基于模板创建新提示词,通过变量调整内容。它不是简单收藏,而是动态生成工具。官方定位是「为大规模生产高质量提示词奠定基础」。
LangGPT 适合什么场景:从内容创作到客服
LangGPT 主要面向五类典型场景:内容创作、代码编写、数据分析、教育辅导与客户服务。每个场景都能通过模板和变量快速构建提示词。
内容创作场景中,作家和营销人员可以用模板生成文章大纲或广告文案。代码编写场景中,程序员可以用模板生成代码片段。
内容创作与代码编写:结构化生成大纲与代码片段
内容创作场景下,用户选择「文案专家」模板,填写产品信息、目标受众、语气风格。模型按模板生成广告文案。作家可以用「故事大纲」模板生成章节结构。
代码编写场景下,程序员选择「代码助手」模板,定义编程语言、框架、代码风格。模型按模板生成代码片段。变量可以指定函数名、参数类型。这比自由文本提示更精确。
数据分析与教育辅导:查询语句与个性化材料
数据分析场景中,分析师用模板定义数据表结构、查询需求、输出格式。模型生成 SQL 查询语句。变量可以指定表名、字段名。这减少了语法错误。
教育辅导场景中,教师用模板生成个性化练习题。变量指定学生年级、知识点、难度。模型按模板输出题目和解析。学生也可以用模板生成学习材料。
客户服务:构建智能客服系统
客户服务场景中,用户设计客服角色提示词。模板包含角色描述、常见问题、响应规则、升级流程。模型按模板响应客户咨询。
工作流定义客服交互步骤:问候、询问、解决、确认。Reminder 保持客服语气一致。这能提高服务质量,减少人工介入。
LangGPT 更新了哪些新东西:近期版本与功能变化
根据 GitHub 提交记录,LangGPT 近期更新包括打字机光标优化、清空聊天历史、自定义 temperature/top_p、移动端修复、多语言支持。这些更新集中在 v2.10.7 到 v2.11.0 版本。
v2.11.0 添加了自定义采样参数,v2.10.9 添加了 socks5 代理认证。移动端修复和韩语翻译也在近期完成。
v2.11.0 增强:自定义采样参数与复制反馈
v2.11.0 版本添加了自定义 temperature 和 top_p 参数。temperature 控制输出随机性,top_p 控制候选词范围。用户可以在设置中调整这两个值。
该版本还优化了复制代码反馈效果。用户点击复制按钮后,界面反馈更清晰。贡献者 quzard 提交了相关代码。
BugFix 与多语言:移动端修复与韩语翻译
近期 BugFix 涉及四类问题:移动端、默认语言、ESM 与 PWA。贡献者 idawnwon 修复了默认语言错误。
多语言方面,Kamilake 添加了韩语翻译。这扩大了用户群体。移动端体验问题部分修复,但仍有用户反馈。
LangGPT 的局限性与已知问题:用户吐槽与缺失功能
LangGPT 存在几个已知问题。插件功能依赖 OpenAI API 函数调用,移动端体验不完善,文档不够清晰。这些问题来自 GitHub issue 和社区反馈。
插件功能基于 LangChain 实现,需要 OpenAI API 函数调用。转发 GitHub Copilot 接口无法使用插件。移动端问题在多个版本中反复出现。
插件功能依赖 OpenAI API:转发接口无法调用
LangGPT 的插件功能基于 LangChain 实现,调用 OpenAI API 函数。如果用户使用转发 GitHub Copilot 接口或类似模拟接口,插件无法正常工作。官方 README 明确警告了这一点。
这意味着使用非官方接口的用户无法使用搜索、RAG 等插件。他们只能使用基础对话功能。这限制了部分用户的功能体验。
移动端体验与文档问题:用户反馈汇总
移动端体验问题在 GitHub issue 中多次被提及。例如,界面布局错乱、按钮点击不灵敏。部分问题在 v2.10.7 和 v2.11.0 中修复,但仍有残留。
文档问题包括说明不清晰、示例过少。新用户可能不知道如何配置环境变量。官方文档更新速度慢于代码迭代。
LangGPT 的集成生态:API、插件与 Webhook 扩展
LangGPT 支持 API 调用和基于 LangChain 的插件功能。社区还提出了 Webhook 扩展需求。这些集成能力扩展了工具的应用范围。
API 支持让用户通过程序调用 LangGPT。插件功能实现搜索、RAG 等能力。Webhook 需求目前尚未实现。
API 与插件:LangChain 函数调用实现搜索等能力
LangGPT 通过 API 与外部服务交互。插件功能基于 LangChain 实现,支持搜索、RAG、语音输入等。搜索插件优先级为 GoogleCustomSearch、SerpAPI、BingSerpAPI 等。
RAG(检索增强生成,让 AI 能查询外部知识库后再回答)功能需要配置嵌入模型。如果不配置,WebBrowser 和 PDFBrowser 插件无法使用。语音输入需要 HTTPS 访问。这些功能扩展了 LangGPT 的应用场景。
Webhook 扩展:社区需求与未来方向
GitHub issue #575 提出了增加 openapi 和 webhook 支持的需求。用户希望 LangGPT 能通过 Webhook 与其他服务集成。该 issue 目前仍处于 Open 状态。
Webhook 支持将允许 LangGPT 接收外部事件触发。例如,当有新数据时自动生成报告。目前尚无官方实现时间表。
参考资料
- SegmentFault 思否(2023-05-20)— 介绍 LangGPT 的系统性、灵活性、交互友好性及关键语法。
- CSDN(2024-09-13)— 提供 LangGPT-tools 的安装与使用示例。
- GitHub(2023-10-11)— 记录 v2.11.0 等版本的自定义采样参数、移动端修复、韩语翻译等更新。