
LLaMA-Factory Online 是什么:定位与核心卖点
LLaMA-Factory Online 是与开源项目 LLaMA-Factory 官方合作的在线大模型微调平台。该平台于 2025 年正式推出,面向编码基础薄弱的开发者。用户无需配置本地环境,通过浏览器即可完成从数据上传到模型微调的全流程。
官方合作背景与推出时间
LLaMA-Factory 是北航开源的低代码大模型训练框架,在 GitHub 上拥有大量用户。LLaMA-Factory Online 与该项目官方合作,将本地框架的能力搬到云端。平台底层提供高性能 GPU 算力,支持分布式训练。上线活动期间(截止 2025 年 10 月),注册用户可领取 50 元无门槛代金券。
零代码可视化微调流程
该平台提供 Web 界面,用户通过点选配置参数,无需编写代码。数据上传、模型选择、训练启动、监控导出均在浏览器完成。平台内置 LlamaBoard 面板,实时展示训练状态。这种设计让微调操作从命令行脚本转变为表单填写。
目标用户:编码基础薄弱的开发者
平台定位明确:帮助那些有微调需求但工程能力基础的用户。比如个人开发者、初创团队、高校科研人员。他们可能了解模型概念,但不熟悉 CUDA 环境配置或 PyTorch 训练循环。LLaMA-Factory Online 将这部分复杂度封装起来。
LLaMA-Factory Online 主要功能:从模型支持到实验监控
平台功能覆盖模型选择、训练算法、精度设置、优化技术、监控工具等维度。以下逐条说明。
100+ 主流模型支持
平台支持 100 多个主流开源大模型,涵盖 LLaMA、Qwen、DeepSeek、GPT-OSS、Mistral、Gemma、ChatGLM、Phi 等系列。用户可在同一平台切换不同架构的模型,无需为每个模型单独配置环境。
训练算法:SFT、PPO、DPO、KTO
平台集成多种训练方法。基础微调支持预训练和监督微调(SFT)。强化学习支持 PPO(近端策略优化)、DPO(直接偏好优化)、KTO(Kahneman-Tversky 优化)、ORPO 等。不同算法有场景指导:PPO 适合追求 SOTA 效果的大厂;DPO 适合中小型团队;KTO 适合预算敏感项目。
运算精度:16bit 到 2bit QLoRA
平台支持从 16bit 全参数微调到 2/3/4/5/6/8bit 的 QLoRA 微调。全参数微调精度高但显存占用大。QLoRA 通过量化降低显存需求。例如 4bit QLoRA 可在单张 24G 显存上微调 7B 模型。用户根据硬件预算选择精度。
优化技术与实验监控
平台集成 GaLore、BAdam、LoRA+、PiSSA、DoRA、rsLoRA 等优化算法。FlashAttention-2 和 Unsloth 加速算子提升训练速度。实验监控内置 LlamaBoard、TensorBoard、Wandb、Mlflow、SwanLab 等工具。用户可实时查看损失曲线和评估指标。
LLaMA-Factory Online 新手上手:注册到首次微调
注册后 5 分钟内可启动第一个训练任务。以下描述典型流程。
注册与代金券领取
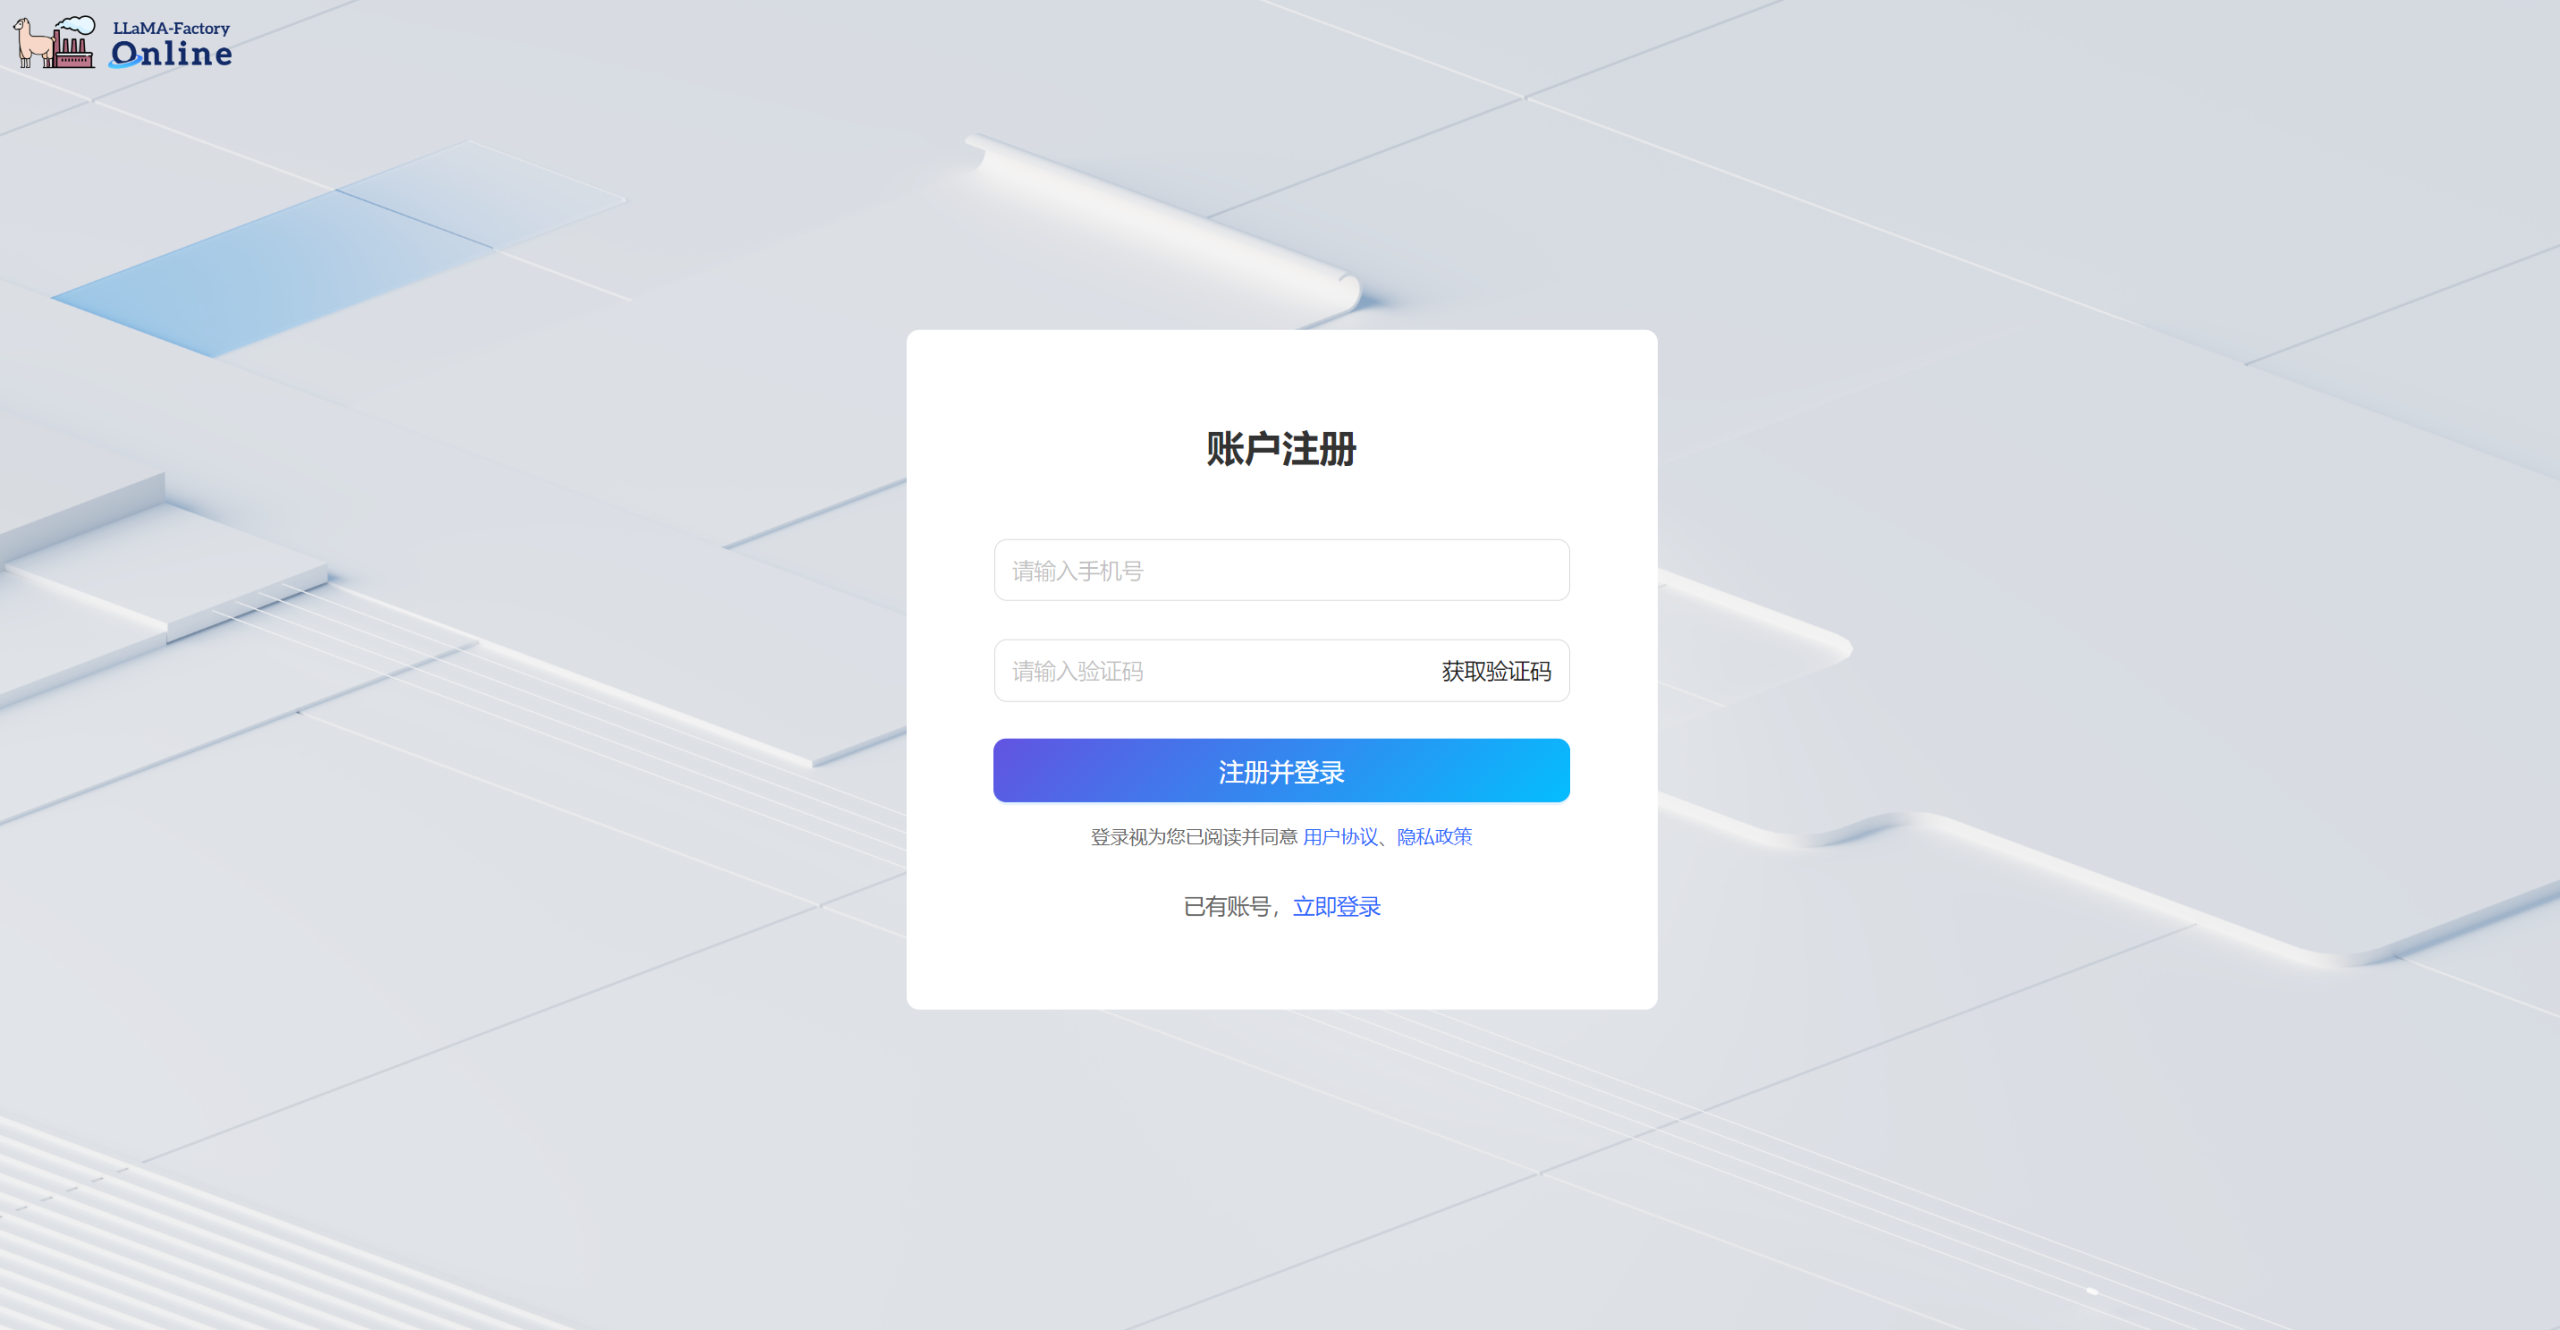
访问官网,用手机号注册登录。注册后通常会看到 50 元无门槛代金券。该券可免费使用高性能 GPU 算力约 6.5 小时。平台采用秒级计费,不用时关机零花费。
选择模型与数据集
从 100+ 模型中选择基座模型,如 Qwen3-8B。数据集支持上传 JSON 或 JSONL 格式。平台也预置 Stanford Alpaca、BELLE 等公开数据集。用户可在在线 Jupyter 环境中清洗数据。
配置微调参数并启动训练
通过可视化界面设置 LoRA 秩、学习率、训练轮数等参数。选择训练方法(全参数、LoRA、QLoRA)。选择算力模式(极速尊享、动态优惠、灵动超省)。点击开始后任务进入队列。
监控训练与导出模型
通过 LlamaBoard 查看损失曲线和训练进度。训练完成后可导出 LoRA 权重。平台支持一键部署为 API 服务,或导出标准格式模型文件。
LLaMA-Factory Online 对比主流替代品
与本地部署、GPU 租赁平台、Hugging Face AutoTrain 相比,各有取舍。
对比本地 LLaMA-Factory 部署
本地部署需要自备 GPU、配置 CUDA 环境、安装依赖。LLaMA-Factory Online 省去这些步骤。但本地部署一次性投入硬件后无按量费用。云端按 GPU 时长计费,长期频繁使用成本可能更高。
对比 AutoDL 等 GPU 租赁平台
AutoDL 提供裸 GPU 实例,用户需自行安装 LLaMA-Factory 及依赖。LLaMA-Factory Online 预装微调框架,无需手动配置。但 AutoDL 价格可能更低,且提供更灵活的硬件选择。
对比 Hugging Face AutoTrain
AutoTrain 是 Hugging Face 的自动训练工具,支持多种任务。LLaMA-Factory Online 更侧重中文模型支持,强化学习算法更丰富。AutoTrain 以英文为主,中文模型覆盖较少。
| 特性维度 | 易用性 | 成本 | 模型支持 |
|---|---|---|---|
| LLaMA-Factory Online | 可视化界面,零代码 | 按量计费,低至 4.6 元/时 | 100+ 主流模型 |
| 本地部署 | 命令行,中代码量 | 硬件一次性投入高 | 社区支持的所有模型 |
| AutoTrain | API 接口,低代码 | 按使用量付费 | 有限的主流模型 |
LLaMA-Factory Online 实际应用:三个典型场景
以下案例来自公开报道或平台宣传。
智能家居企业微调生产级模型
某智能家居企业使用该平台,耗时 10 小时完成生产级交互模型微调。开发周期缩短 67%,模型性能提升 50% 以上。该案例说明平台可支撑企业级任务。
2 小时打造专业医疗助手
用户基于 Qwen3-8B 模型,使用医疗对话数据集,2 小时内微调出医疗助手。该助手能提供症状分析和就医建议。这展示了垂直领域快速定制的可行性。
个人开发者低成本实验
利用 50 元代金券,个人开发者可免费体验全流程。6.5 小时 GPU 时长足够完成小型微调实验。这降低了尝试门槛。
LLaMA-Factory Online 的核心亮点:降本增效
平台价值体现在技术门槛、硬件成本、实验效率三方面。
降低技术门槛:无需编写代码
可视化操作替代命令行与脚本。用户无需掌握 PyTorch 训练循环或 CUDA 配置。参数设置通过表单完成。这扩大了潜在用户群。
节省硬件成本:按量计费
无需一次性采购 GPU。平台按 GPU 时长计费,低至 4.6 元/时。不用时关机不产生费用。适合预算有限的个人和小团队。
提升实验效率:统一平台
一个平台切换不同模型与算法。无需为每个模型单独搭建环境。实验对比更方便。
LLaMA-Factory Online 最近更新:平台动态
平台持续迭代,模型库和算法不断扩充。
2025 年上线活动与代金券
截止 2025 年 10 月,注册用户可领取 50 元无门槛代金券。该活动已结束,但平台可能推出新优惠。
模型与算法持续扩充
平台支持 100+ 模型,覆盖最新开源模型。2025 年新增 Qwen2.5、DeepSeek-V2 等支持。强化学习算法稳定性持续优化。
LLaMA-Factory Online 国内可用性:访问与支付
平台面向国内用户设计,访问和支付无障碍。
国内访问与中文界面
官网可直连,无需特殊网络环境。界面全中文,文档也为中文。这对国内用户友好。
支付方式与计费模式
支持人民币支付。计费按 GPU 时长,秒级精度。提供多种算力模式,价格从 4.6 元/时起。
LLaMA-Factory Online 替代品推荐
如果该平台不满足需求,可考虑以下备选。
本地部署 LLaMA-Factory
适合有 GPU 且熟悉命令行的用户。开源免费,可完全控制环境。但需要自行解决依赖和硬件问题。
Hugging Face AutoTrain
国际平台,支持多种任务。英文为主,中文支持有限。适合英文场景或已有 Hugging Face 生态经验的用户。
阿里云 PAI-DSW
国内云平台,提供 Jupyter 环境。需自行配置 LLaMA-Factory。适合需要更多控制权的用户。