
“海狮”国家级大模型 是什么:核心定位
“海狮”国家级大模型(SEA-LION)是新加坡国家人工智能计划(AISG)主导开发的东南亚语言大模型。它的全称是“东南亚语言一体化网络”,专门解决东南亚多语言环境下的 AI 理解与生成需求。据公开报道,这个项目始于 2023 年 12 月,新加坡政府投入 7000 万新元(约 5200 万美元)专项资金。
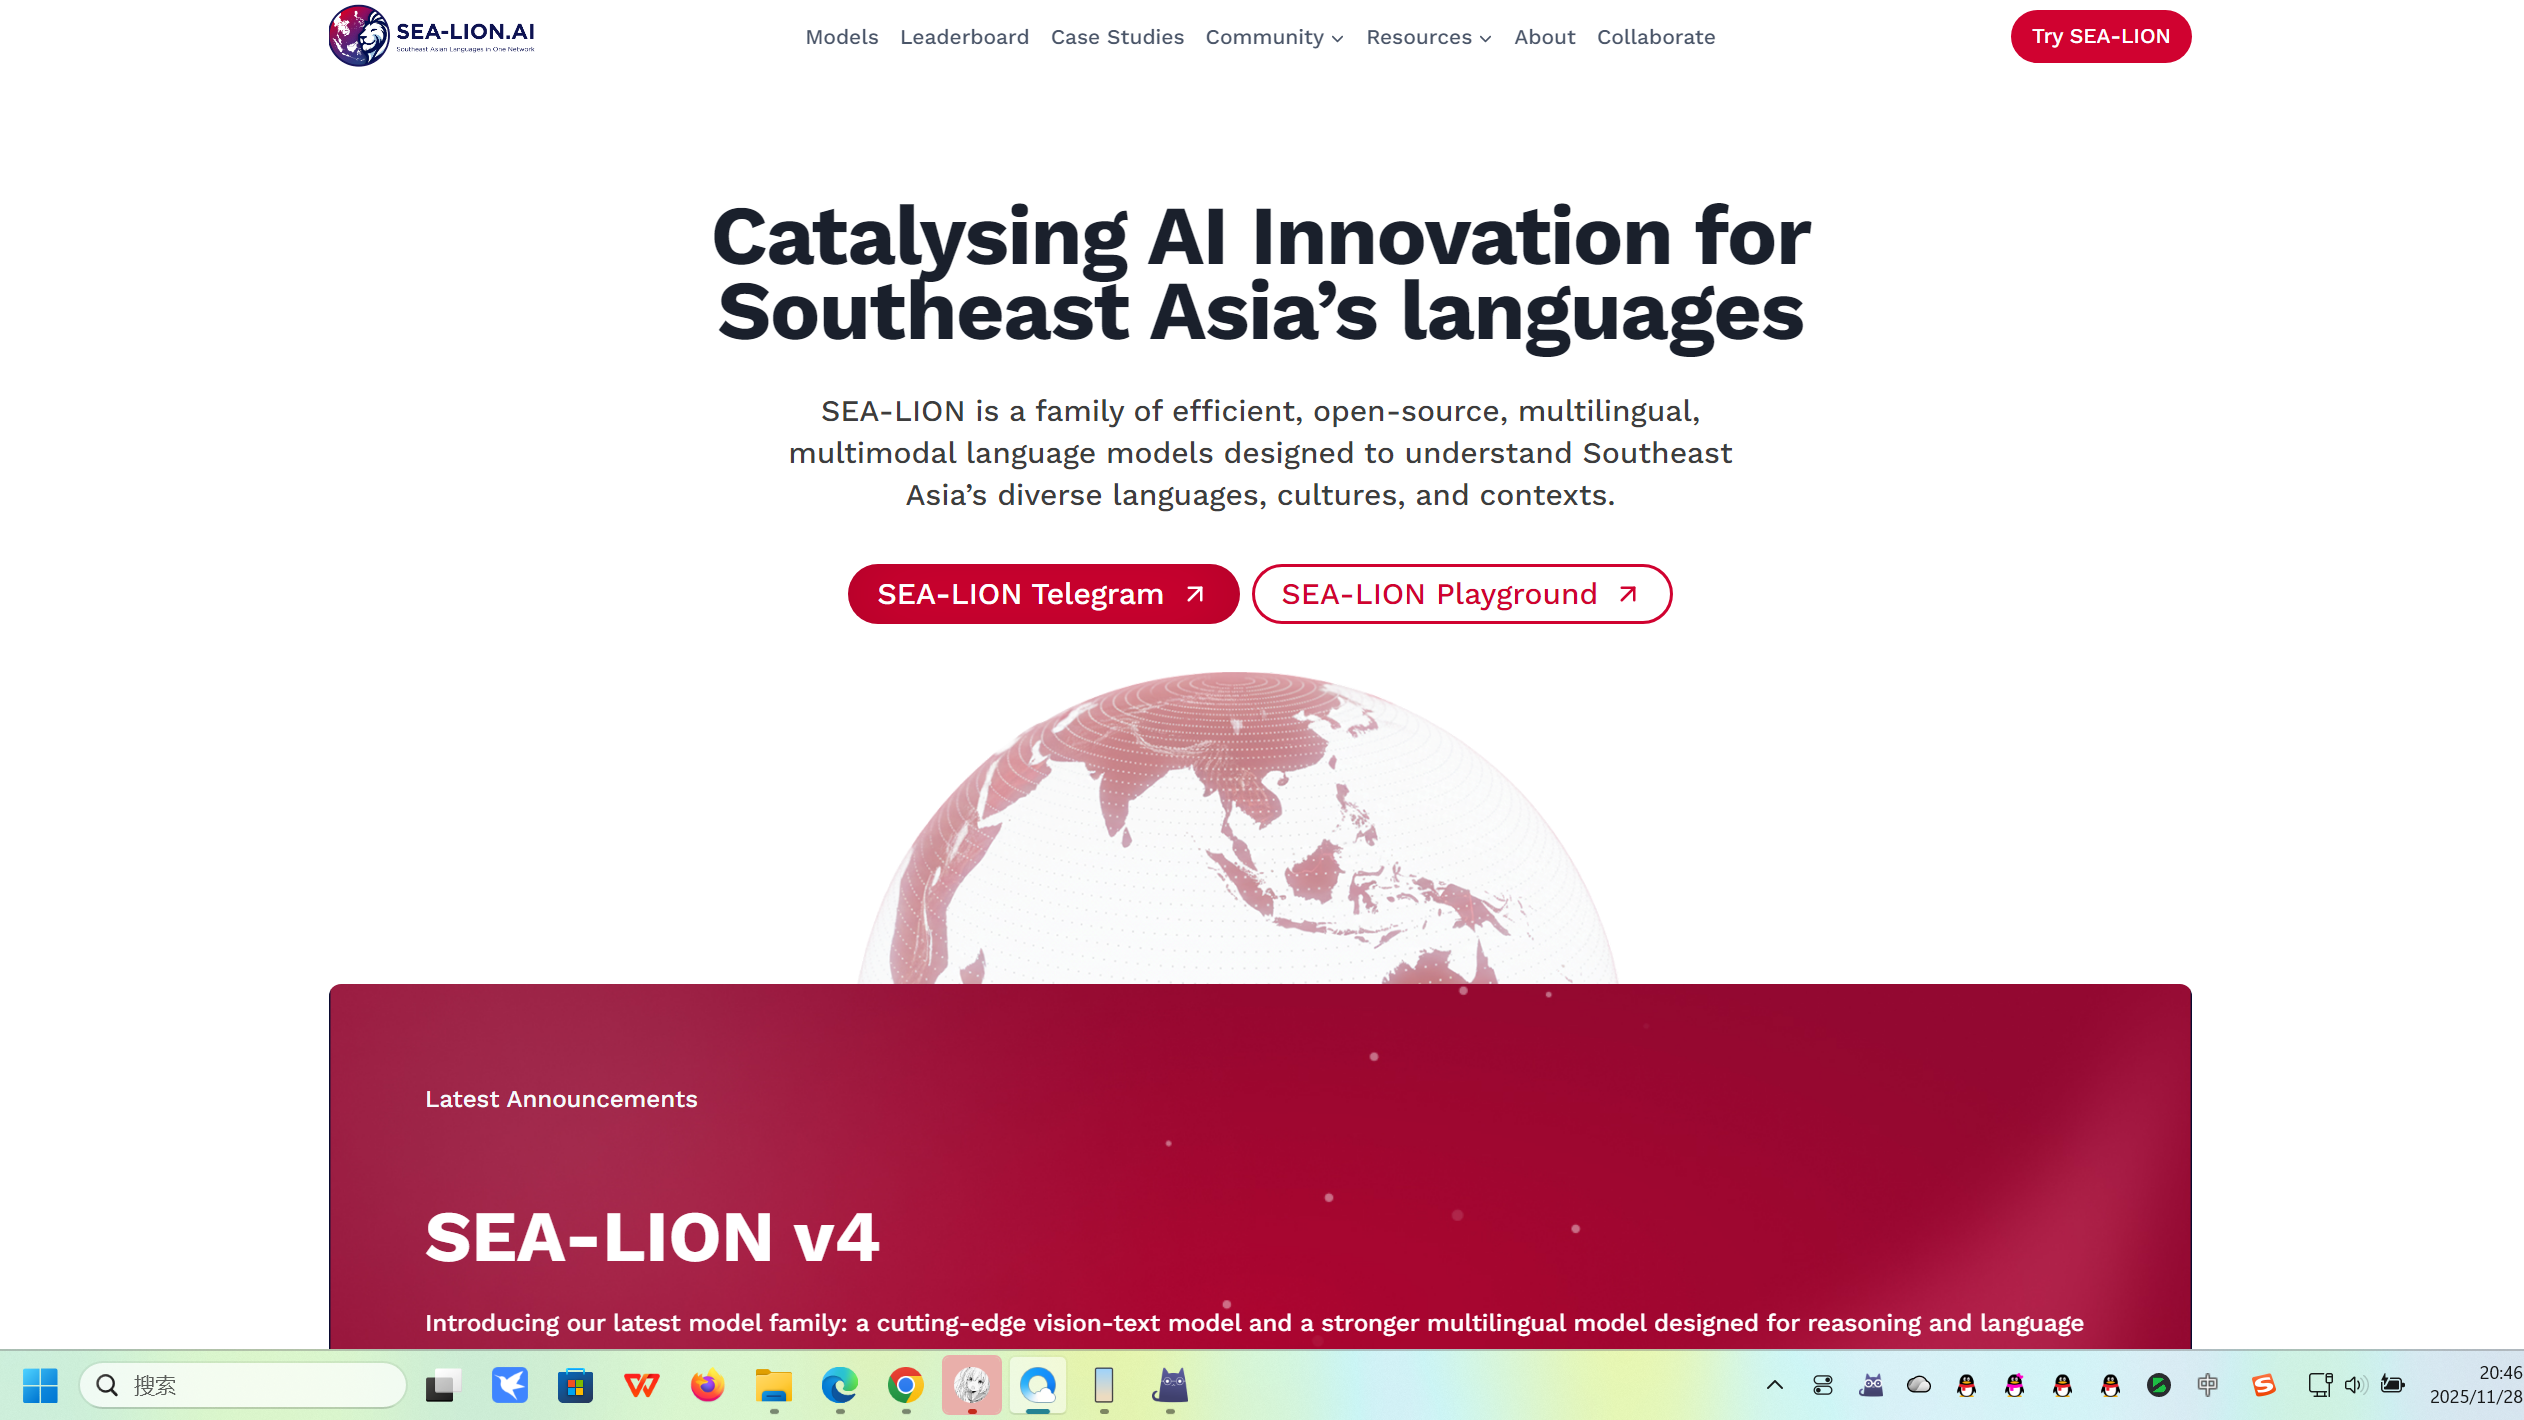
最新发布的 v4 版本有一个重大变化:基座模型从美国 Meta 的 Llama2 全面转向中国阿里通义千问 Qwen3-32B。这不是简单换壳,而是深度区域化适配。东南亚有 6 亿人口,数字经济规模逼近万亿美元,但主流 AI 模型对当地语言的支持长期不足。
从Llama2到Qwen3:一次技术路线的转向
早期版本基于 Llama2,效果并不理想。公开测试中,旧版甚至把南美洲的委内瑞拉错误列为东盟成员国。这种区域常识错误暴露了西方基座模型对东南亚数据的严重缺失。
转向 Qwen3-32B 的原因很直接:阿里千问在多语言和推理能力上表现更强,而且开源协议允许自由商用。AISG 贡献了 1000 亿个东南亚语言 token,这些数据经过清洗、无版权风险。东南亚内容浓度达到 13%,是 Llama2 的 26 倍。
核心功能:四个方向的能力拆解
这款多语言大模型的核心能力集中在四个方向:原生多语言支持、区域文化适配、运行效率、性能表现。每个方向都针对东南亚实际使用场景做了专门优化。
原生多语言:基座广覆盖与东南亚专门优化
多语言能力的来源要分两层看。基座 Qwen3-32B 在预训练阶段使用了约 36 万亿个 token,覆盖全球 119 种语言和方言。海狮 v4 在此基础上做继续预训练,注入 1000 亿个东南亚语言 token,专门优化 11 种语言。这不是后期打补丁,而是从底层理解语法结构。印尼语、马来语等主要语言能准确捕捉语义和文化细微差别。
对于泰语、缅甸语等非拉丁语系文字,模型采用字节对编码(BPE)分词器。这类文字通常没有明显的词间空格,传统分词方法容易出错。BPE 分词器有效解决了这个难题。
区域文化适配:语码转换和Singlish
东南亚居民日常交流中经常在英语里夹杂方言,比如新加坡式英语(Singlish)或马来西亚式英语(Manglish)。传统美式 AI 模型对这种混合语境理解困难。
该平台针对“语码转换”现象做了专门优化。AISG 贡献的 1000 亿东南亚语言 token 中,包含大量真实对话数据。模型能准确把握其中的文化梗和语言习惯,而不是机械翻译。
运行效率:32GB笔记本本地部署
经过专门优化后,模型可以在配备 32GB 内存的消费级笔记本电脑上流畅运行。东南亚中小企业开发者仅凭一台高配电脑就能本地部署这个国家级模型。
这种“工业级能力,民用级门槛”的特性,大幅降低了使用成本。算力资源相对稀缺的地区也能用上先进 AI 能力,不需要依赖昂贵的云服务。
性能表现:Sea-Helm 榜单表现
据媒体报道,在 Sea-Helm 评估榜单上,v4 版本迅速占据同量级开源模型榜首。东南亚语言处理任务的准确性远超之前的 Llama2 版本。
旧版基于 Llama2 训练时,几乎是个“东南亚文盲”。v4 版本彻底修复了区域常识错误。这说明基座模型的选择对区域化AI至关重要。
怎么用起来:三种获取与使用路径
获取和使用该模型有三种主要方式:开源下载、本地部署、API 调用。不同用户可以根据自己的技术能力和需求选择合适路径。
开源获取:以 Hugging Face 为主
模型权重已在 Hugging Face 官方主页发布,开发者可以免费下载模型权重和配置文件。ModelScope 是否同步上架,以 AISG 官方公告为准。
截至 2025 年 11 月,v4 版本刚发布不久,相关资源正在逐步开放。建议关注 AISG 官方公告获取最新下载链接和文档。
本地部署:32GB内存的消费级门槛
开源模型部署的基本要求是 32GB 内存以上,GPU 可选但非必需。具体步骤包括:环境准备、模型获取、本地加载、微调定制(可选)、集成应用。
AISG 预计会提供详细的开发文档和最佳实践指南。技术团队按文档逐步操作,可以跑通完整的部署流程。
API调用:新加坡数据隐私合规
通过官方 API 服务使用时,需遵循新加坡及东南亚地区的数据隐私法规,具体数据政策以 AISG 官方说明为准。
对于不想自己维护模型的企业,API 调用是更省心的选择。但需要注意,API 服务可能产生计算资源费用,具体定价需联系 AISG。
和竞品对比:Llama2 和 Qwen3 原版差在哪
与 Llama2、Qwen3 原版、其他东南亚语言模型相比,该工具在东南亚语言处理上的差异化优势集中在数据浓度和本地化适配深度。
| 特性维度 | 海狮 v4 | Meta Llama2 | Qwen3 原版 |
|---|---|---|---|
| 基座与训练 | Qwen3-32B 基座,注入 1000 亿东南亚 token | Meta 自研基座 | 预训练 36 万亿 token,覆盖 119 种语言 |
| 东南亚内容浓度 | 13% | 0.5% | 未单独披露 |
| 语码转换支持 | Singlish、Manglish 专门优化 | 混合语境理解困难 | 无专门优化 |
| 开源商用 | 允许免费商用 | 开源但有使用限制 | 开源可商用 |
| 部署门槛 | 32GB 内存消费级设备可运行 | 通常需要专业 GPU | 32B 规模,消费级可运行 |
对比Llama2:东南亚内容浓度26倍差距
Llama2 训练数据中,东南亚语言内容仅占 0.5%。这个数字意味着模型几乎没见过真实的东南亚语料。
该平台将这一比例提升到 13%,是 Llama2 的 26 倍。这直接解释了为什么旧版会犯委内瑞拉被列为东盟成员国的错误。数据浓度决定了模型对区域常识的掌握程度。
对比Qwen3原版:区域化适配的价值
该工具不是简单包装 Qwen3。AISG 在 Qwen3-32B 基座上进行了深度后训练,注入 1000 亿东南亚语言 token。
原版 Qwen3 虽然多语言能力很强,但缺乏对 Singlish、Manglish 等混合语境的专门优化。区域化适配让模型在处理东南亚实际对话时更自然、更准确。
适合你吗:三个实际使用场景
如果你是东南亚市场的企业或开发者,这个模型值得重点关注。以下场景最能体现它的价值。
东南亚语言客服:听懂Singlish和Manglish
假设你运营一个面向新加坡和马来西亚的客服系统。用户可能会说“Can lah, I want to return this item”,这种混合英语方言让传统模型困惑。
该工具能准确理解这类表达,并给出符合当地习惯的回复。客服对话的准确率和用户满意度会明显提升。
本地内容生成:印尼语马来语泰语
如果需要为东南亚市场生成营销文案或社交媒体内容,这个模型比通用模型更懂本地文化。
比如为印尼电商写产品描述,它会使用当地人熟悉的表达方式,而不是生硬翻译。马来语、泰语内容同样适用。
本地部署:中小企业数据不出防火墙
对于数据敏感的金融、医疗行业,本地部署是刚需。32GB 内存的消费级门槛让中小企业也能负担。
客户数据完全留在自己的服务器上,不经过第三方云服务。这符合新加坡和东南亚多国的数据保护法规。
使用海狮模型的好处和坏处
任何工具都有两面性。这个模型在东南亚语言任务上优势明显,但通用能力受限于基座模型规模。
好处:东南亚语言准确率大幅提升
相比西方通用模型,这款多语言大模型在印尼语、马来语、泰语等语言的理解准确率显著更高。文化适配让对话更自然,减少误解。
对于东南亚市场的企业,这意味着更低的本地化成本和更高的用户满意度。
好处:消费级硬件降低部署成本
32GB 笔记本即可运行,不需要昂贵的 GPU 集群。开源模型部署门槛的大幅降低,让中小企业省下大量云服务开支。
开源协议允许免费商用,没有供应商锁定风险。数据自控也符合合规要求。
坏处:通用能力依赖Qwen3基座
非东南亚语言任务的表现受限于 Qwen3-32B 的规模。如果用户需要处理大量英文或中文内容,原版 Qwen3 或更大模型可能更合适。
该工具的区域化优化在通用任务上不会带来额外提升。选择前需要明确自己的主要使用场景。
这次更新带来了什么:v4 的两个变化
v4 版本的核心变化是基座模型从 Llama2 转向 Qwen3-32B。这个技术转型带动了多项指标提升。
v4技术转型:从美国模型到中国模型
放弃 Llama2 是一个战略决策。Qwen3-32B 在多语言能力和推理性能上更强,而且开源协议更友好。
这次转型不是简单替换,而是深度双向融合。阿里提供通用推理底座,AISG 贡献区域数据。
性能跃升:榜单成绩与常识修复
据媒体报道,Sea-Helm 榜单上 v4 版本位居同量级第一。旧版的区域常识错误被彻底修复。这说明基座模型的选择对区域化AI的成败至关重要。
“海狮”国家级大模型 的优点和缺点
综合来看,这个模型有两个突出优点和一个明显缺点。
优点:东南亚语言专门优化
预训练阶段就注入高浓度东南亚数据,不是后期微调。这让模型对当地语言的理解更深入、更自然。
优点:开源和本地部署自由
无供应商锁定,数据自控。企业可以自由修改和分发模型,符合主权 AI 的需求。
缺点:通用知识依赖基座模型
非东南亚任务的表现受限于 Qwen3-32B 的规模。如果需要处理复杂推理或大量非东南亚语言内容,直接选原版 Qwen3 或更大规模的模型更合适。
国内可用性:在中国大陆怎么用
从中国大陆访问 Hugging Face 可能受限。模型本身开源,可关注 ModelScope 是否同步上架,或参考 AISG 官方渠道获取权重。
访问渠道:以官方渠道为准
如果 ModelScope 同步上架,国内开发者下载速度和连接稳定性会更好。目前是否上架,需以 AISG 官方公告为准。
Hugging Face 在国内访问不稳定,可能需要代理。获取模型权重时,建议以官方文档给出的渠道为准。
中文界面和支付:开源模型无订阅费
本地部署完全免费,没有月费或订阅费。API 服务需联系 AISG,具体定价未公开。
开源模型没有中文界面,但文档和社区支持基本够用。对于国内开发者,技术门槛不算高。
行业地位:东南亚主权 AI 的代表项目
新加坡政府投入 7000 万新元,AISG 主导,这是东南亚主权 AI 的代表项目。
政府背景:7000万新元专项资金
这笔资金用于建立多模态大型语言模型的研究和工程能力。新加坡的目标是拥有自主可控的区域 AI 能力。
区域影响:东南亚数字包容的标杆
为 6 亿人口市场提供本土化 AI 能力,减少对西方模型的依赖。这个模式可能被其他地区借鉴。
底层模型技术栈:从基座到后训练
基座是阿里 Qwen3-32B 开源模型,AISG 进行区域化适配和后训练。
基座模型:Qwen3-32B的参数规模
32B 参数,开源可商用。这个规模在消费级硬件上可运行,同时保持较强推理能力。
训练数据:token 构成与 BPE 分词器
基座 Qwen3 的预训练覆盖 119 种语言。海狮 v4 的继续预训练聚焦东南亚语言,针对非拉丁语系做了优化。BPE 分词器处理泰语、缅甸语等无空格文字。
后训练:高级后训练注入区域知识
AISG 用 1000 亿东南亚 token 做深度适配。这些数据浓度 13%,是 Llama2 的 26 倍。
参考资料
- SEA-LION 官方文档(2025-11-24)— Qwen-SEA-LION-v4-32B 模型卡
- Sea-Helm 榜单(2025-11-24)— 东南亚语言能力评估榜单
- 腾讯网(2026-08-07)— 阿里 Qwen 开源模型收费计划报道
- 手机搜狐网(2024-07-10)— 新加坡海狮大模型相关报道