Deepgram 是什么:语音 AI 平台与核心卖点
Deepgram 是一家成立于 2015 年的语音 AI 公司,提供语音转文本(STT)、文本转语音(TTS)和音频智能三组 API。开发者通过
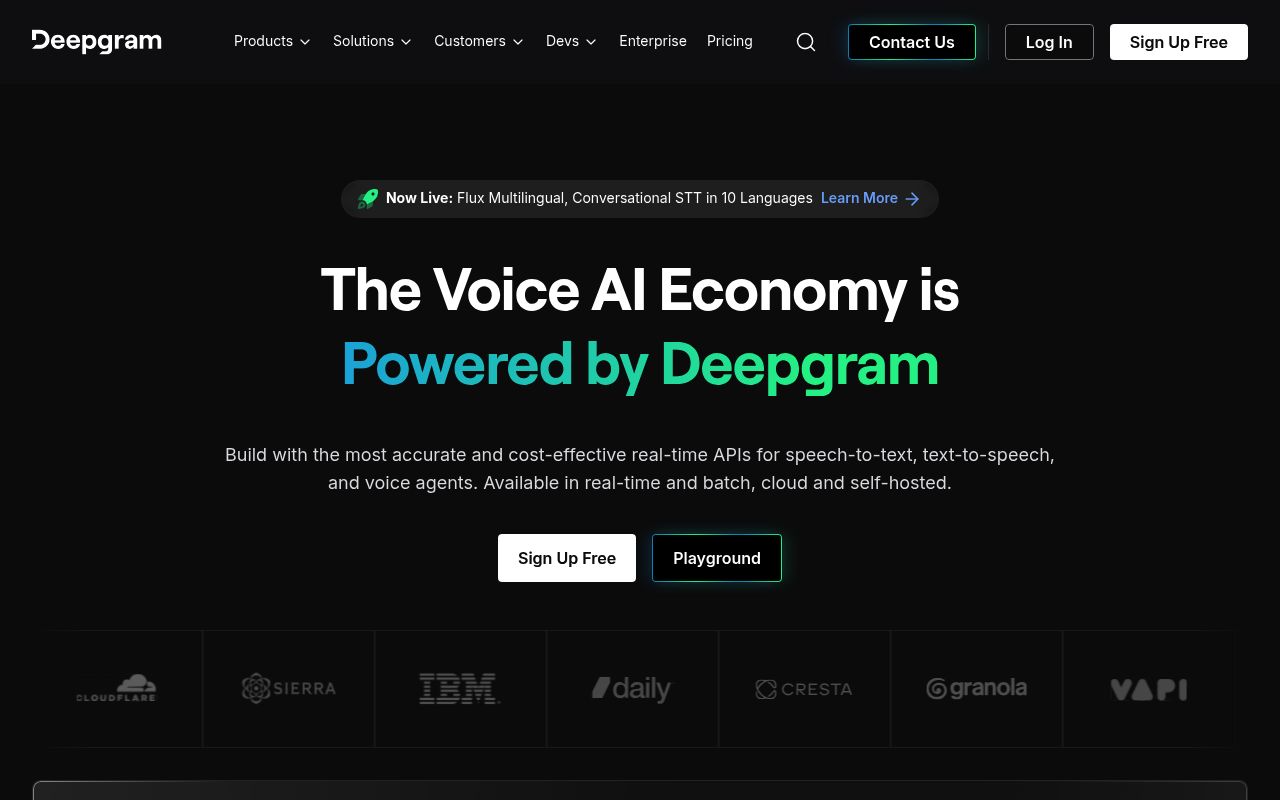
HTTP请求或 WebSocket 连接即可调用这些能力,无需自建模型。该平台的核心卖点在于低延迟与高吞吐:官方宣称预录音频转录速度可达 120 倍实时,流式转录延迟低于 300 毫秒。
- 语音转文本:支持实时流式与预录音频两种模式,输出带时间戳和置信度分数的文本。
- 文本转语音:Aura 模型提供低延迟语音合成,适合对话式 AI 代理。
- 音频智能:包括摘要、情感分析、说话者分离等自然语言理解功能。
- 部署灵活:支持云端、本地和私有云环境,满足数据合规需求。
语音转文本、文本转语音与音频智能三组 API
- 语音转文本 API:接收音频流或文件,返回结构化文本。支持 30 多种语言和方言,能处理噪声、多说话人场景。
- 文本转语音 API:Aura 系列模型生成自然语音,延迟指标面向实时对话优化。
- 音频智能 API:在转录基础上附加语言检测、文本摘要、说话者识别、情感分析等能力。
谁在调用 Deepgram:从呼叫中心到医疗转录
呼叫中心使用该平台转录通话并分析情感,媒体团队批量处理播客和视频,医疗机构将临床语音转为可检索文本。语音助手开发者则利用低延迟 TTS 构建对话式 AI。公开案例显示,Wistia、Revenue.io 等公司已将其集成到视频营销和销售分析流程中。
Deepgram 主要功能:从转录到定制模型
- 预录或流式转录:支持 40 多种音频格式,输出标点、大小写和话语跟踪。
- 多模型选择:提供通用、电话、会议、对话式 AI 和财报电话专用模型。
- 关键字提升:对行业术语、产品名称临时加权,无需重新训练模型。
- 定制模型训练:上传标注数据训练专属模型,官方称训练准确率可达 90% 以上。
- 音频时间戳与置信度:每个词附带时间偏移和置信度分数,便于下游处理。
- 说话者分离:自动区分不同说话人,输出按人分类的转录稿。
- 脏话过滤与编辑:可配置敏感词过滤,支持自动标点。
语音转文本:实时流式与预录音频
实时流式转录通过 WebSocket 连接持续接收音频分片,返回增量结果。官方数据称延迟低于 300 毫秒。预录音频模式则提交完整文件,一小时音频约 12 秒转完,相当于 120 倍实时速度。两种模式共用同一套模型,但流式模式对网络稳定性要求更高。
自然语言理解:摘要、情感与说话者分离
- 文本摘要:从长转录中提取关键信息,生成简短摘要。
- 情感分析:判断每段话的情感倾向,输出正面、负面或中性标签。
- 说话者分离:识别不同说话人并分别标注,适合会议和访谈场景。
- 语言检测:自动识别音频语种,无需预先指定。
定制模型与部署选项
定制模型通过上传标注音频训练,适合术语密集的垂直行业。关键字提升则无需训练,直接在请求中指定需加权的词汇。部署方面,该平台支持云端 API 调用,也可部署到本地服务器或私有云。本地部署适合对数据出域有严格限制的企业。
Deepgram 怎么用起来:注册到首次转录
- 注册账户:访问官网,用邮箱或 GitHub 账号创建账户。
- 获取 API 密钥:控制台生成密钥,格式为
dg_开头的一串字符。 - 打开控制台:查看用量、管理密钥、访问 Playground 试用。
- 调用 API:用 cURL 或 SDK 发送音频,接收转录结果。
注册后 5 分钟内会看到什么
注册后进入控制台,默认显示 API 密钥管理页面。新账户通常带有 200 美元免费积分,可访问所有公共模型。控制台左侧导航包含 Playground、用量统计和文档链接。Playground 允许上传音频文件或粘贴音频 URL,无需写代码即可查看转录结果。
API 密钥与首个 cURL 请求
在控制台「API Keys」页面点击「Create Key」生成密钥。最小可运行的 cURL 请求如下:
curl -X POST https://api.deepgram.com/v1/listen \
  -H "Authorization: Token dg_your_key_here" \
  -H "Content-Type: audio/wav" \
  --data-binary @sample.wav
返回 JSON 包含 transcript 字段和逐词时间戳。注意密钥不要硬编码在客户端代码中,应通过环境变量注入。
Python SDK 与流式转录配置
- 安装 SDK:
pip install deepgram-sdk。 - 初始化客户端:
DeepgramClient(api_key)。 - 配置流式连接:指定
model参数,如nova-3。 - 注册回调函数:处理
onTranscript事件,接收增量结果。 - 发送音频分片:将麦克风或音频流按小块发送。
流式转录需处理 is_final 标志,区分中间结果和最终结果。SDK 支持自动重连,但网络中断时可能丢失部分音频。
Deepgram 与主流工具对比:AssemblyAI、Whisper 怎么选
| 比较维度 | Deepgram | AssemblyAI | OpenAI Whisper |
|---|---|---|---|
| 部署方式 | 云 API / 本地 / 私有云 | 云 API | 自托管或本地运行 |
| 流式转录 | 支持,延迟 <约 300ms | 支持 | 需自行实现流式处理 |
| 定制模型 | 支持训练与关键字提升 | 支持自定义词汇 | 需微调或提示工程 |
| 计费模式 | 按量计费,无 15 秒取整 | 按量计费 | 免费(自托管成本另计) |
| 典型延迟 | 预录音频 120 倍实时 | 未公开 | 取决于硬件 |
价格模型:按量计费与免费积分
新账户提供 200 美元免费积分,可访问所有端点和公共模型。Growth 版年费约 4K 至 10K 美元,提供折扣。按量计费根据模型和音频时长计算,官方强调无 15 秒取整,即按实际处理时长收费。具体单价需查看定价页面,不同模型差异较大。
准确率与延迟:Deepgram 的实测数据
- 一小时预录音频转录约 12 秒,即 120 倍实时速度。
- 流式转录延迟低于 300 毫秒。
- 定制模型训练准确率官方称可达 90% 以上。
- 成本比同类产品低 3 至 5 倍,来自官方宣传数据。
- 平均准确率提升 30%,该数据来自第三方评测,需结合具体音频场景理解。
Deepgram 典型应用场景:四个落地路径
- 呼叫中心:通话转录与情感分析。
- 媒体与内容:播客、视频批量转录和索引。
- 医疗转录:临床语音转结构化文本。
- 语音助手:低延迟 TTS 配合对话式 AI。
呼叫中心:通话转录与情感分析
电话模型针对 8kHz 采样率优化,能处理信道噪声和双方重叠语音。说话者分离功能将客服与客户分开标注,情感分析标记不满通话。企业可将转录结果接入质检系统,自动评分并生成合规报告。
播客与视频:批量转录和内容索引
媒体团队使用预录音频端点批量处理素材。转录结果带时间戳,可直接生成字幕文件或内容索引。Wistia 的案例显示,视频平台将转录集成到 AWS Marketplace 流程中,提升内容可搜索性。
医疗与语音代理:低延迟 TTS 的配合
医疗转录需处理大量专业术语,定制模型或关键字提升可提高准确率。语音代理场景中,Aura TTS 生成回复语音,与 STT 配合形成完整对话回路。低延迟 TTS 减少用户等待时间,让交互更接近真人对话。
Deepgram 实际收益:成本、速度与开发效率
- 转录速度:120 倍实时,批处理任务耗时大幅缩短。
- 成本节省:官方称比同类低 3 至 5 倍,无 15 秒取整。
- 集成时间:官方称 10 分钟内可完成首次调用。
- 开发效率:SDK 支持
Python、JavaScript、.NET 等语言。
一小时音频 12 秒转完意味着什么
120 倍实时速度意味着 10 小时音频约 5 分钟处理完毕。批处理任务不再需要通宵运行,媒体团队可在编辑周期内快速迭代。对于实时性要求不高的场景,速度优势直接转化为计算成本下降。
比同类低 3-5 倍的成本如何构成
成本优势来自自研 GPU 基础设施和端到端深度学习架构。按量计费无 15 秒取整,短音频不会按最小单位收费。定制模型训练后无需持续关键字提升,长期使用可进一步降低单价。
Deepgram 的最新动态:Aura TTS 与模型迭代
Aura 文本转语音模型于近期推出,主打低延迟和自然音色。nova-3 是当前默认语音转文本模型,在准确率和噪声鲁棒性上较前代有提升。SDK 方面,JavaScript 客户端持续更新,.NET 预发布包已上架 NuGet。
Aura 文本转语音:低延迟对话式 AI 的补全
Aura 定位为对话式 AI 的语音输出端,延迟指标面向实时交互优化。与通用 TTS 不同,Aura 针对短句回复和快速轮次设计,减少用户等待。开发者可将 Aura 与 STT 组合,构建完整语音代理。
SDK 与部署更新:JS 客户端与 .NET 预发布包
- deepgram-js-sdk 最新版本修复了浏览器端
process is undefined错误,并增加自定义 fetch 配置。 - NuGet 上提供 Deepgram.Unstable.SDK.Builds 预发布包,目标框架为 .NET 6.0 和 .NET Standard 2.0。
- Python SDK 持续维护,支持流式转录和异步回调。
Deepgram 替代品推荐:两个备选路径
什么时候选 AssemblyAI 而不是 Deepgram
AssemblyAI 在特定 NLU 任务上提供更细粒度的 API,如实体识别和内容审核。如果项目需要开箱即用的音频智能功能,且不希望自己组合多个端点,AssemblyAI 可能更合适。但 AssemblyAI 的流式延迟和定制模型能力与 Deepgram 存在差异,需实测对比。
自托管 Whisper 的取舍
OpenAI Whisper 免费且可本地运行,适合数据敏感或预算有限的团队。但 Whisper 需要自行搭建服务、处理并发和流式逻辑,工程成本较高。Deepgram 的托管 API 省去运维负担,但按量付费长期成本可能更高。
Deepgram 适用人群画像:哪些团队该优先评估
- 需要低延迟流式转录的实时应用团队。
- 有定制词汇需求的垂直行业开发者。
- 处理大量预录音频的媒体或数据团队。
- 对数据出域有严格限制、需要本地部署的企业。
需要低延迟流式转录的实时应用团队
语音代理、呼叫中心质检、实时字幕等产品对延迟敏感。Deepgram 的流式端点延迟低于 300 毫秒,适合这类场景。团队应关注 WebSocket 连接的稳定性和断线重连策略。
有定制词汇需求的垂直行业开发者
医疗、法律、金融等领域充满专有名词。关键字提升可快速改善识别效果,定制模型训练则能从根本上提高准确率。官方称训练准确率可达 90% 以上,但需准备一定量的标注音频。
参考资料
- CSDN(2024-12-30)— 语音识别平台对比,提及 Deepgram 定制化模型能力。
- deepgram.com(2024-11-15)— 官方案例研究,包含 Wistia、Revenue.io 等客户场景。
- blog.deepgram.com(2025-01-29)— 官方博客,产品更新与公告。
- GitHub(2024-04-30)— deepgram-js-sdk 发布记录,含浏览器端 bug 修复。