AssemblyAI 是什么:语音 AI 基础设施定位
AssemblyAI 是面向开发者的语音 AI 平台,提供预录音频、实时和同步语音转写 API,支持 99 种语言。该平台强调自研语音 AI 模型和自托管部署能力。根据官网公开数据,其服务获数百万开发者使用。
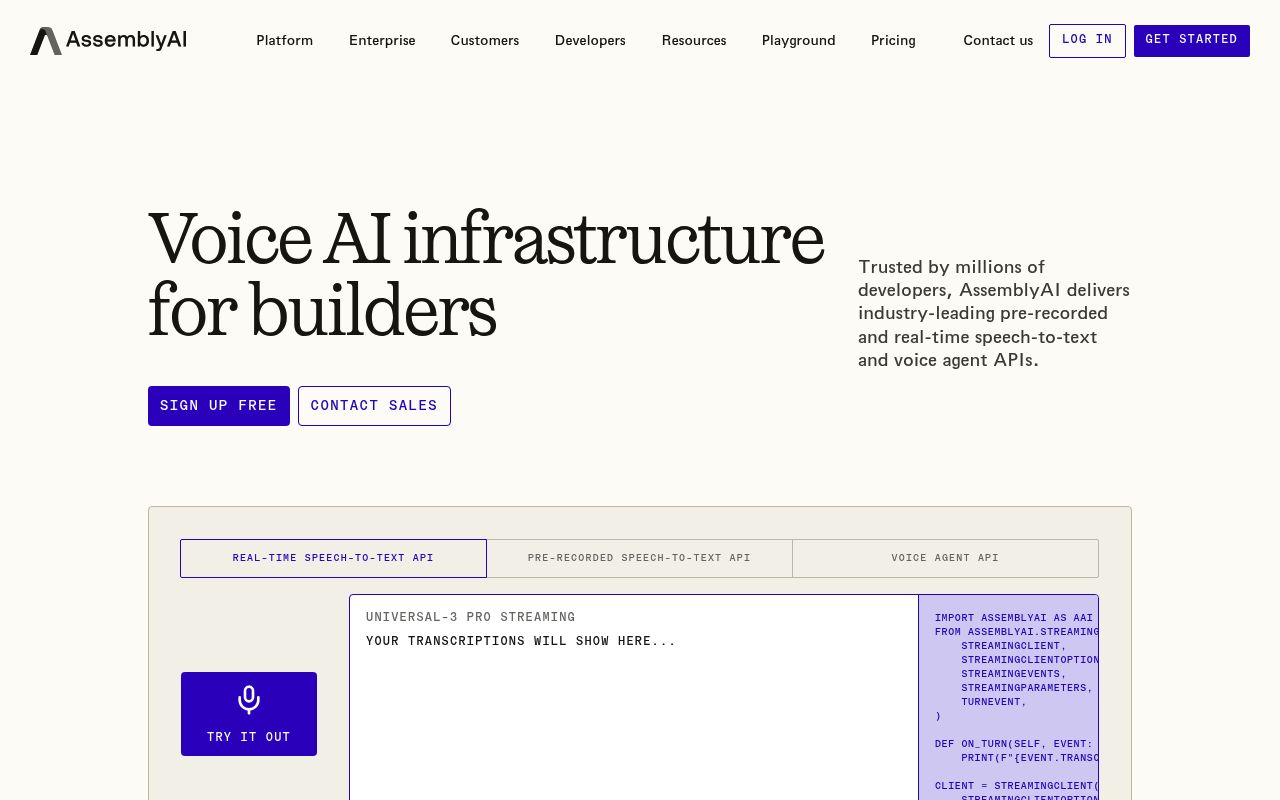
该工具的核心定位是自动语音识别(ASR,将语音转换为文字的技术)基础设施,即通过 API 让开发者将语音转文字、语音理解等功能嵌入自己的产品。它不提供面向普通用户的独立应用,而是以程序调用接口的形式交付能力。
从技术架构看,该平台采用深度神经网络训练语音 AI 模型。官方文档显示,其研究团队每隔几周发布一次模型改进。这种持续迭代模式在语音 API 领域较为常见,但具体版本更新频率尚无第三方独立验证。
API 端点与支持格式
主要 REST API 端点包括 /v2/transcript 和 /v2/lemur,实时流式转录通过 WebSocket 端点 wss://api.assemblyai.com/v2/realtime/ws 完成。其中 /v2/transcript 用于异步转录预录音频,/v2/lemur 用于将大语言模型应用于转录文本。
支持音频格式包括 mp3、wav、m4a 等常见格式。视频格式同样支持,但官方文档未列出完整清单。根据公开资料,该平台可处理所有主流音频和视频格式。
异步处理是该平台的重要特性。用户可以上传大文件,无需保持连接等待结果。系统处理完成后通过回调或轮询方式返回转录文本。
系统要求与 SDK 兼容性
官方维护 Python 和 JavaScript 两门语言的 SDK(软件开发工具包,帮助开发者快速接入服务的代码库),Go、Java 等为社区维护。根据 GitHub 仓库信息,Python SDK 可通过 pip install -U assemblyai 安装。具体最低版本要求未在公开文档中明确列出。
API 密钥获取方式为:在 assemblyai.com 注册账号,进入控制台创建 API 密钥。该密钥用于所有 API 调用的身份验证。
SDK 设计目标是简化集成流程。官方声称几分钟内即可开始使用任何语言,但实际集成时间取决于开发者经验。目前尚无第三方基准测试验证这一说法。
AssemblyAI 功能列表:从转写到语音理解
该平台的核心功能分为两类:音频转写(语音转文字)和语音理解。语音转文字包括 Universal-3.5 Pro 模型、说话人分离。语音理解包括情感分析、章节检测、PII 编辑、内容审核、主题检测、实体检测和摘要生成。
以下逐条列出核心功能:
- 语音转文字:使用 Universal-3.5 Pro 模型,支持 99 种语言
- 说话人分离:区分多个说话人并输出标签
- 情感分析:对每句话输出正面/负面/中性评分
- 章节检测:自动将长音频分割为章节
- PII 编辑:自动识别并移除敏感信息
- 内容审核:检测仇恨言论等违规内容
- 主题检测:识别口语主题
- 实体检测:提取人名、组织等实体
- 摘要生成:生成不同长度的文本摘要
语音转文字:Universal-3.5 Pro 模型
Universal-3.5 Pro 是该平台最新的旗舰音频转写模型。根据官方 Benchmarks 页数据,该模型平均词错率为 4.35%。这一数据来自官方发布,未经第三方独立验证。
该模型支持 99 种语言,包括全球英语及各种口音。自定义词汇表功能允许用户添加专业术语,提高特定领域的识别准确率。
噪声鲁棒性是官方强调的重点。模型针对真实环境音频进行了优化,例如电话通话、会议录音等场景。但具体鲁棒性提升幅度尚无量化数据。
说话人分离与说话人标签
说话人分类功能(diarization,又称说话人分离)用于区分音频中的多个说话人。系统会为每个单词输出对应的说话人标签,如 Speaker A、Speaker B。
该功能适用于会议记录、访谈、播客等多说话人场景。官方文档显示,该功能可自动检测说话人变化,无需预先指定人数。
实际准确率受音频质量影响。在重叠语音、背景噪声严重的情况下,分离效果可能下降。目前尚无公开的独立评测数据。
情感分析与内容审核
情感分析模型对每句话输出正面、负面或中性评分。该功能可用于客户通话分析、社交媒体监测等场景。
内容审核 API 可检测仇恨言论等违规内容。该功能与情感分析相互独立,但可组合使用。
官方未公开情感分析模型的准确率数据。第三方评测也较为有限。因此实际效果需开发者自行测试。
PII 编辑与安全护栏
PII redaction 功能自动识别并移除电话号码、社保号、地址等敏感信息。该功能支持自定义策略,用户可指定需要编辑的信息类型。
安全护栏是平台的重要卖点。对于医疗、金融等合规要求严格的行业,PII 编辑可降低数据泄露风险。
官方文档显示,该功能可应用于转录文本和音频文件。但具体识别准确率未公开。
AssemblyAI 怎么用:从注册到首个转录请求
使用该平台需要完成以下步骤:注册账号、获取 API 密钥、安装 SDK、发起转录请求、轮询结果。以下详细说明每个步骤。
注册与 API 密钥配置
访问 assemblyai.com 注册账号。注册完成后进入控制台,创建 API 密钥。该密钥是访问所有 API 的凭证。
建议将 API 密钥设置为环境变量,避免硬编码在代码中。例如在 Linux/macOS 中使用 export ASSEMBLYAI_API_KEY=your_key。
免费版提供一定额度的调用次数。具体额度以官网定价页为准。超出额度后需付费。
Python SDK 安装与异步转录
安装 Python SDK 的命令为:pip install -U assemblyai。安装完成后,可使用以下代码发起异步转录:
import assemblyai as aai

aai.settings.api_key = "your_api_key"
transcriber = aai.Transcriber()
transcript = transcriber.transcribe("audio.mp3")
print(transcript.text)
该代码上传本地音频文件并等待转录完成。transcribe() 方法会阻塞直到结果返回。对于大文件,建议使用异步模式。
实时流式转录配置
实时转录使用 aai.RealtimeTranscriber 连接 WebSocket。需要设置采样率、编码格式等参数。
import assemblyai as aai

def on_data(transcript):
    print(transcript.text)

transcriber = aai.RealtimeTranscriber(
    sample_rate=16_000,
    on_data=on_data
)
transcriber.connect()
end-of-utterance 控制参数用于调整语音结束检测的灵敏度。该参数影响语音代理的响应延迟。
类似于 AssemblyAI 的工具:Deepgram、Google STT、Whisper
语音转文字 API 领域的主要竞品包括 Deepgram、Google Cloud Speech-to-Text 和 OpenAI Whisper。以下从准确率、语言支持、实时能力、定价和自托管选项五个维度进行对比。
| 比较维度 | AssemblyAI | Deepgram | Google STT | Whisper |
|---|---|---|---|---|
| 语言支持 | 99 种 | 30+ 种 | 125+ 种 | 99 种 |
| 实时转录 | 支持 | 支持 | 支持 | 需自建 |
| 自托管 | 企业版支持 | 企业版支持 | 不支持 | 开源支持 |
| 定价模式 | 按量付费 | 按量付费 | 按量付费 | 免费(自托管) |
| 语音理解功能 | 丰富 | 有限 | 有限 | 无 |
Deepgram:实时转录与低延迟
Deepgram 的 Nova-2 模型在词错率方面与 AssemblyAI Universal-3.5 Pro 相当。根据公开基准测试,两者在标准数据集上的表现接近。
流式延迟方面,Deepgram 宣称低于 300 毫秒。AssemblyAI 未公开具体延迟数据。实际延迟受网络条件影响。
Deepgram 的语音理解功能相对有限,主要聚焦于转写本身。AssemblyAI 在情感分析、PII 编辑等方面更完整。
Google Cloud Speech-to-Text:企业集成
Google STT 的优势在于与 GCP 生态的深度集成。对于已使用 Google Cloud 的企业,接入成本较低。
但在语音理解功能上,Google STT 主要提供基础转写。情感分析、PII 编辑等高级功能需要组合其他 GCP 服务。
AssemblyAI 的差异化在于提供一体化的语音理解 API。开发者无需集成多个服务即可获得完整功能。
OpenAI Whisper:开源与自托管
Whisper 是开源模型,可免费自托管。这降低了初期成本,但需要自行维护服务器和模型更新。
AssemblyAI 提供托管 API,免去维护负担。同时企业版支持自托管部署,兼顾数据控制需求。
成本方面,Whisper 自托管的硬件和运维成本可能高于 API 调用费用。具体取决于使用规模。
AssemblyAI 适合什么场景:语音代理、通话分析、医疗转录
该平台适用于五个典型场景:AI 语音代理、AI 笔记员、通话分析、医疗转录、听写与代理辅助。每个场景使用不同的 API 功能组合。
AI 语音代理:实时交互
构建语音代理需要流式转录和 LLM(大语言模型)集成。流式转录提供低延迟的文本输入,LLM 生成回复,再通过 TTS(文本转语音)输出语音。
该平台提供 end-of-utterance 控制参数,可调整语音结束检测灵敏度。这对语音代理的响应速度至关重要。
官方文档提供了语音代理的 Cookbook 示例。开发者可参考示例快速搭建原型。
通话分析与客户支持
根据官方案例,Siro 使用该平台后客户投诉和支持工单减少 90%。这一数据来自官方发布,未经独立验证。
通话分析场景使用说话人分类、情感分析和摘要生成功能。这些功能组合可自动生成通话报告。
实际效果取决于音频质量和模型准确率。建议开发者先在小规模数据上测试。
医疗转录与 PII 合规
医疗场景对准确率和合规性要求极高。PII 编辑功能可自动移除患者敏感信息。
自定义词汇表可添加医学术语,提高专业词汇识别准确率。HIPAA 合规要求数据加密和访问控制,该平台声称满足相关要求。
但官方未公开 HIPAA 合规的具体认证信息。医疗开发者需自行评估合规性。
AssemblyAI 实际收益:开发效率与成本控制
使用该平台的量化收益包括:减少手动校对时间、降低自建 ASR 成本、通过自托管满足数据驻留要求、利用预训练模型快速上线。
减少手动校对:官方词错率数据
官方 Benchmarks 页显示,Universal-3.5 Pro 平均词错率为 4.35%。这意味着可明显减少人工校对量。
这一数据基于官方测试集。实际词错率因音频质量、口音、领域术语而异。建议开发者使用自己的数据测试。
官方公布的平均词错率在语音识别领域属于较好水平。但并非所有场景都能达到这一指标。
自托管部署:数据不出境
企业版支持在 AWS、GCP、Azure 或本地 Kubernetes 集群部署。这满足 GDPR 和金融行业数据驻留要求。
自托管部署的复杂度较高。需要企业具备 Kubernetes 运维能力。官方提供部署文档,但具体实施成本未公开。
对于数据敏感型企业,自托管是选择该平台的重要原因。
AssemblyAI 这次更新带来了什么:Universal-3.5 Pro 与实时改进
本次更新包括 Universal-3.5 Pro 模型发布、流式转录的 end-of-utterance 控制优化、自托管版本的 Kubernetes 支持。
Universal-3.5 Pro:噪声鲁棒性提升
新模型在真实环境音频上的准确率有所提升。官方强调噪声鲁棒性改进,但未公布具体提升幅度。
支持的 99 种语言覆盖保持不变。自定义词汇表功能继续可用。
该模型适用于电话通话、会议录音等真实场景。
流式转录延迟降低
实时 API 的延迟得到优化。end-of-utterance 控制参数使语音代理响应更快。
官方未公开具体延迟数据。开发者需自行测试实际延迟。
延迟优化对语音代理体验至关重要。
AssemblyAI 总体评价:技术优势与局限
该平台在语音理解功能完整性和自托管选项上具有优势。但定价高于开源方案,且中文方言支持有限。
功能完整性方面,从自动语音识别转写到情感分析、PII 编辑,覆盖了语音 AI 的主要需求。自托管选项满足数据驻留要求。
局限在于定价。相比开源 Whisper,API 调用费用更高。中文方言支持有限,官方未明确列出支持的方言种类。
AssemblyAI 适合什么人用:开发者画像
最适合的用户类型包括:需要快速集成语音功能的 SaaS 开发者、处理多说话人音频的媒体团队、有数据驻留要求的企业。
SaaS 开发者可通过 API 快速添加语音功能,无需自建模型。媒体团队可利用说话人分离和摘要功能处理播客、访谈。
有数据驻留要求的企业可选择自托管部署。
AssemblyAI 国内可用性:访问、中文界面与支付
国内访问 assemblyai.com 的稳定性未知。API 调用是否需要代理取决于网络环境。
中文界面缺失。官网和文档均为英文。支付方式主要为信用卡。发票问题需联系销售团队。
国内开发者需自行解决网络访问和支付问题。
AssemblyAI 行业地位:融资与客户规模
AssemblyAI 创立于 2017 年,总部位于旧金山。据官方博客,累计融资 1.15 亿美元。客户包括 Zoom、Siro 等。
在语音 AI 基础设施领域,该平台与 Deepgram 直接竞争。两者均提供语音转文字 API,但功能侧重不同。
融资规模反映了资本市场对该领域的关注。但行业地位需结合市场份额数据判断,目前无公开市场份额报告。
参考资料
- AssemblyAI 官网(2017-08-04)— 平台定位与核心功能说明
- CSDN 技术博客(2024-10-23)— Python SDK 安装与使用示例
- GitHub AssemblyAI Python SDK(2024-12-30)— SDK 快速开始文档