Apache MXNet 是什么:免费开源的深度学习框架
Apache MXNet 是亚马逊公司于 2017 年捐赠给 Apache 软件基金会的开源深度学习框架。该框架支持创建和训练卷积神经网络、LSTM 网络等模型。与 TensorFlow 相比,它在多语言支持和分布式训练上更灵活。
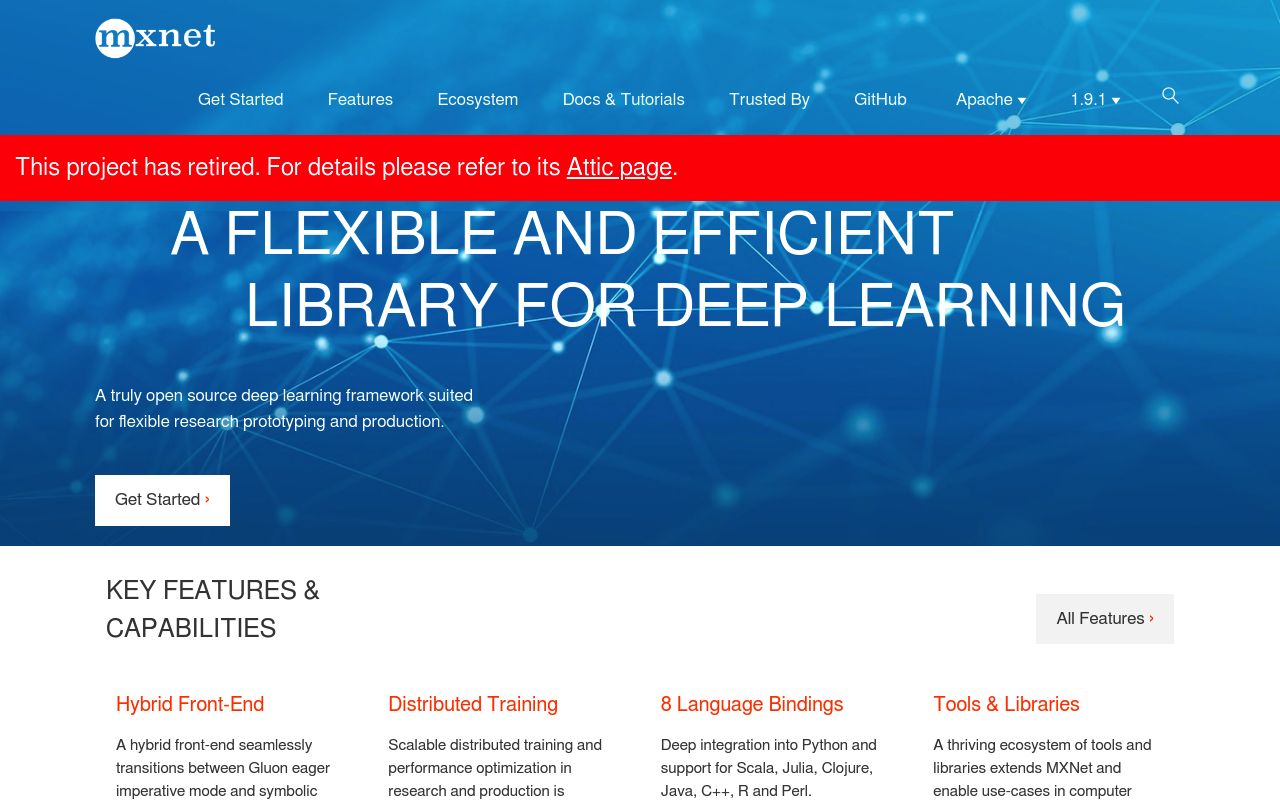
这个框架的核心特点是免费和高度可扩展。它采用 Apache 2.0 许可证,任何人都能自由使用、修改和分发。根据公开数据,AWS 选择 MXNet 作为其深度学习框架,而非 TensorFlow、Theano 或 Torch。
MXNet 的设计理念是模块化和混合编程。该框架允许用户在静态计算图和动态计算图之间自由切换。这种灵活性让研究者和工程师都能找到适合自己的工作方式。
从不用花钱开始:MXNet 的免费基础
假设你是一名学生或独立开发者,预算有限。MXNet 从安装到训练模型都不需要支付任何软件费用。Apache 2.0 许可证明确允许商业使用,没有隐藏条款。
社区支持是免费的另一层含义。该框架由 Apache 软件基金会维护,全球开发者贡献代码和文档。不过,国内用户会发现中文教程和问答相对较少。
如果需要技术支持,官方邮件列表和 GitHub Issues 是主要渠道。该框架没有付费客服,但核心问题通常能在社区得到回应。
Apache MXNet 主要功能:混合编程与分布式训练
MXNet 提供符号式和命令式两种编程模式。符号式类似 TensorFlow,先构建计算图再执行。命令式类似 PyTorch,操作即时执行,更易调试。
Gluon API 是高级接口,类似 Keras。该接口支持动态图计算,让模型构建更直观。开发者仅需几行代码就能构建线性回归、CNN 和循环 LSTM 模型。
多语言支持是 MXNet 的突出特点。该框架原生支持 Python、Scala、R、C++ 和 Julia。相比 TensorFlow 早期仅支持 Python,它对多语言团队更友好。
自动微分功能简化了梯度计算。MXNet 的自动微分引擎能高效处理复杂函数的梯度,减少手动推导错误。
一行代码切换多 GPU:训练加速的实操
假设你有一台配备 3 个 GPU 的服务器。在 MXNet 中,只需修改 context 参数即可实现数据并行训练。
import mxnet as mx
# 单 GPU
module = mx.module.Module(context=mx.gpu(0))
# 多 GPU
module = mx.module.Module(context=[mx.gpu(i) for i in range(3)])
默认情况下,MXNet 使用数据并行化划分工作负载。每个 GPU 接收完整模型副本,并处理训练数据批次的三分之一。这种设计让扩展变得简单直接。
Gluon API 能做什么:快速构建 CNN 和 LSTM
Gluon API 提供面向对象的神经网络构建方式。该接口支持动态图计算,适合快速原型开发。
对于物体检测、语音识别和推荐引擎等任务,Gluon 能显著减少代码量。例如,构建一个卷积神经网络只需定义层序列和前向传播函数。
Gluon 还支持 HybridBlock,可以混合使用符号式和命令式编程。这样既能享受动态图的调试便利,又能获得静态图的执行效率。
Apache MXNet 新手上手指南:从安装到第一个模型
安装 MXNet 前,需要确认 Python 版本和硬件环境。官方提供 pip 和源码编译两种方式。对于大多数用户,pip 安装最简单。
核心操作流程包括:定义数据迭代器、构建模型、选择损失函数和优化器、训练循环。MXNet 的 Python 接口设计直观,有经验的开发者能快速上手。
官方提供一张速查表,帮助开发者快速查阅常用 API。这张表对新手尤其有用,减少了记忆负担。
安装 MXNet:选择你的语言和硬件
MXNet 支持 Windows、Linux 和 macOS 操作系统。硬件方面,CPU、GPU 和 TPU 均可运行。
安装命令因语言而异。Python 用户执行 pip install mxnet 即可。R 用户可以从 CRAN 安装,Scala 用户使用 Maven 依赖。
如果使用 GPU,需要安装对应版本的 CUDA 和 cuDNN。官方文档提供了详细的版本匹配表。
用 Python 写一个线性回归:Gluon 快速上手
假设你需要快速验证一个线性回归模型。使用 Gluon API,代码可以非常简洁。
from mxnet import gluon, nd
from mxnet.gluon import nn

net = nn.Sequential()
net.add(nn.Dense(1))
net.initialize()
loss = gluon.loss.L2Loss()
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': 0.01})
这段代码定义了单层全连接网络,使用 L2 损失和随机梯度下降。训练循环只需几行,就能看到损失下降。
Apache MXNet 和类似工具怎么选:与 TensorFlow、PyTorch 对比
选择深度学习框架时,分布式训练、多语言支持和易用性是关键维度。MXNet 在这三方面各有优劣。
| 比较维度 | Apache MXNet | TensorFlow | PyTorch |
|---|---|---|---|
| 分布式训练 | 原生支持,近线性扩展 | 支持,但配置较复杂 | 需额外工具 |
| 多语言支持 | Python、Scala、R、C++、Julia | 主要 Python,其他语言有限 | 主要 Python |
| 易用性 | 中等,Gluon 较友好 | 静态图,学习曲线陡 | 动态图,调试方便 |
TensorFlow 的生态系统更庞大,部署工具更丰富。PyTorch 在学术研究中占主导,动态图调试体验好。MXNet 在云基础设施和分布式场景有优势。
MXNet 的分布式优势:128 个 GPU 快 109 倍
Amazon Web Services 运行的测试发现,在包含 128 个 GPU 的集群中,MXNet 的性能比使用单个 GPU 快 109 倍。这个数据来自公开报道,展示了该框架的近线性扩展能力。
MXNet 采用分布式参数服务器架构,可以使用多个 GPU 或 CPU 实现近线性扩展。深度学习工作负载能跨多个 GPU 自动分配。
这种扩展性让 MXNet 成为云上大规模训练的有力候选。AWS 选择它作为默认深度学习框架,正是看中这一点。
PyTorch 更易调试,MXNet 更省内存
PyTorch 的动态图机制让调试更直观。你可以随时打印中间变量,逐步排查问题。MXNet 的命令式模式也支持类似操作,但混合模式下调试稍复杂。
内存效率方面,MXNet 的图形优化层使符号执行更快、内存效率更高。根据公开资料,该框架的低内存占用适合大规模数据训练。
如果调试是首要需求,PyTorch 可能更合适。如果内存受限或需要大规模分布式训练,MXNet 值得考虑。
Apache MXNet 用户实际体验:在哪些场景下最顺手
MXNet 并非适合所有场景。该框架在云基础设施、移动端部署和多语言团队中表现突出。
云基础设施上的大规模训练
假设你在 AWS 上训练一个大型推荐模型。MXNet 与 Amazon SageMaker 深度集成,可以无缝使用云端 GPU 集群。
该框架从设计之初就为云环境优化。分布式参数服务器和自动并行化让多机训练配置简单。
实际体验中,用户只需指定设备列表,MXNet 就能自动分配工作负载。这比手动配置 TensorFlow 集群要省时。
移动端和嵌入式部署的轻量选择
MXNet 库可移植且规模小巧。该框架支持在智能手机、嵌入式设备上部署模型。
该框架提供模型压缩和量化工具,能减小模型体积。对于边缘计算场景,这是一个实用优势。
假设你需要将图像分类模型部署到树莓派。MXNet 的轻量级运行时和跨平台支持让这个过程更简单。
Apache MXNet 能带来什么好处:具体收益与 ROI
使用 MXNet 的收益主要体现在训练时间节省和团队协作成本降低。
训练时间减半:分布式训练的直观回报
假设一个模型在单 GPU 上需要训练 10 天。使用 128 个 GPU 的 MXNet 集群,根据 109 倍加速数据,训练时间可缩短到约 2.2 小时。
这种时间节省直接转化为研发效率。团队可以更快迭代模型,尝试更多超参数组合。
多语言支持降低团队成本。Python、Scala、R 开发者可以共用同一框架,减少跨语言迁移的学习投入。
Apache MXNet 的优点和缺点:坦诚的评估
MXNet 的优点和缺点同样明显。选择前需要权衡。
优点:多语言、分布式、混合编程
多语言支持是 MXNet 的差异化优势。一个团队中,数据科学家用 R,工程师用 Scala,都能在同一框架下工作。
分布式训练能力经过 AWS 大规模验证。109 倍加速数据来自公开测试,可靠性较高。
混合编程模式让用户可以在动态图和静态图之间切换。这兼顾了调试便利和执行效率。
缺点:学习曲线和社区规模
对于初学者来说,MXNet 的学习曲线相对陡峭。Gluon API 虽然友好,但底层概念仍需时间理解。
国内用户的知名度和相关资源较少。中文教程、问答和预训练模型都比 TensorFlow 和 PyTorch 少。
社区规模较小意味着遇到冷门问题时,可能需要更长时间等待解答。
Apache MXNet 的性价比分析:免费框架的隐藏成本
免费不等于零成本。使用 MXNet 需要投入硬件和人力。
免费不等于零成本:硬件和人力投入
训练深度学习模型需要 GPU。一块中端 GPU 价格在数千元,高端 GPU 更贵。云上租用 GPU 实例按小时计费。
学习 MXNet 需要时间。有 Python 基础的开发者,一周可以跑通第一个模型。但精通分布式调优需要数月实践。
这些成本与使用 TensorFlow 或 PyTorch 类似。免费省下的是软件许可费,而非全部开销。
何时升级到云托管服务:Amazon SageMaker 的取舍
假设你的团队需要频繁训练大规模模型。自建 MXNet 集群需要维护服务器、处理故障。
Amazon SageMaker 提供托管训练服务,内置 MXNet 容器。用户只需上传脚本,无需管理基础设施。
但 SageMaker 按小时收费,长期使用成本可能高于自建。如果训练任务不频繁,自建 MXNet 更经济。
Apache MXNet 的学习曲线:从入门到能训练模型
MXNet 的上手难度中等。有 Python 基础的开发者可以快速开始。
有 Python 基础:一周跑通第一个模型
假设你熟悉 Python 和基本机器学习概念。按照官方教程,第一天安装 MXNet,第二天学习 NDArray 和自动微分。
第三天用 Gluon 构建线性回归,第四天尝试 CNN。第五天可以训练一个简单的图像分类模型。
这个学习路径基于官方文档和社区教程。实际进度因人而异,但一周跑通第一个模型是合理目标。
文档和社区:英文资源为主
MXNet 的官方文档质量较高,覆盖安装、教程、API 参考。但大部分内容为英文。
中文资源相对匮乏。CSDN、知乎上有一些教程,但系统性和时效性不如英文资料。
遇到问题时,GitHub Issues 和英文论坛是主要求助渠道。这对英文不熟练的用户是一个障碍。