MLX 是什么:苹果芯片上的阵列框架
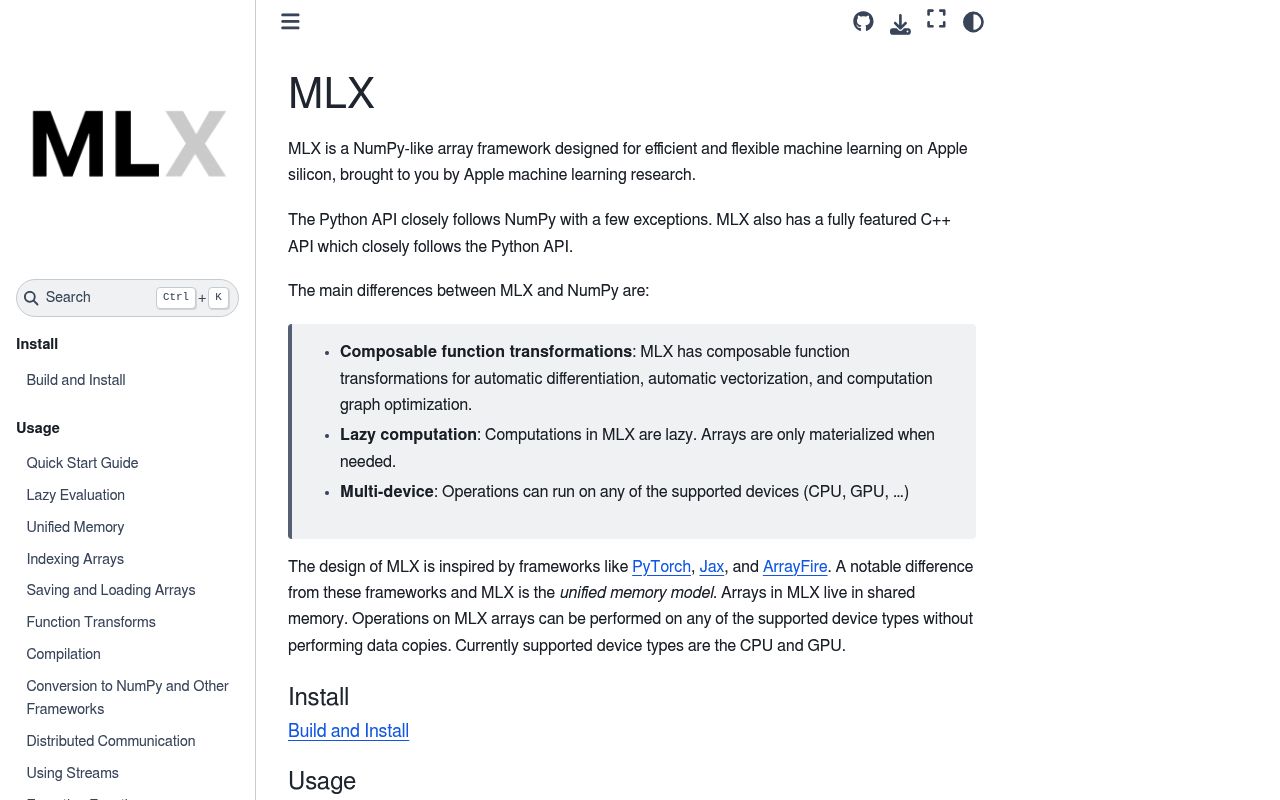
MLX 是苹果机器学习研究团队推出的阵列框架,专为 Apple Silicon 芯片设计。它从 NumPy、PyTorch、JAX 和 ArrayFire 中吸取灵感,核心卖点是统一内存模型。
- 定位:面向 Mac 上机器学习开发、训练和部署的开源框架。
- 核心卖点:统一内存,数组共享内存,无需在 CPU 和 GPU 之间复制数据。
- 设计哲学:API 熟悉、计算惰性、图动态构建,降低上手门槛。
该工具与 PyTorch、JAX 直接竞争,但在 Mac 上优势明显。关键区别在于内存管理方式。
从 NumPy 到 MLX:熟悉的 API 与设计取舍
MLX 的 Python API 与 NumPy 紧密一致。这意味着如果你写过 NumPy 代码,几乎不用学新语法。更高层的 mlx.nn 和 mlx.optimizers 则遵循 PyTorch 约定。
这种设计取舍很明确:降低学习曲线,吸引已有 NumPy 或 PyTorch 经验的开发者。但代价是,它不像 JAX 那样完全函数式,也不像 PyTorch 那样生态庞大。
统一内存模型:为什么 Mac 上不需要搬数据
传统框架中,CPU 和 GPU 有各自显存。数据要在两者间来回拷贝,耗时且占内存。MLX 不同。数组存在共享内存里,操作可以在任何支持的设备上执行,无需移动数据。
这直接减少了数据搬运开销。对 Mac 用户来说,训练和推理都更快,内存占用也更低。
MLX 主要功能一览:从惰性计算到动态图
- 惰性计算:数组只在需要时具体化,避免不必要的中间结果。
- 可组合函数转换:自动微分、自动向量化、计算图优化,三者可组合使用。
- 动态图构建:改变函数参数形状不会触发缓慢编译,调试直观。
- 多设备支持:操作可在 CPU 或 GPU 上运行。
- 统一内存:数组共享内存,无需设备间复制。
这些功能共同降低了 Mac 上机器学习开发的门槛。
惰性计算:数组只在需要时具体化
MLX 中的计算是惰性的。你写下一串操作,它不会立即执行。只有当你真正需要结果时,数组才会被创建。
这带来两个好处:一是减少内存占用,二是允许计算图优化。比如,多个操作可以合并,避免中间数组的存储。
可组合函数转换:自动微分与向量化
MLX 支持可组合的函数转换。你可以用 grad 求梯度,用 vmap 自动向量化,用 compile 优化计算图。
这些转换可以叠加。比如先向量化再求梯度,或者先优化再微分。这种灵活性让模型训练和科研实验更高效。
动态图构建:调试更直观,无需等待编译
与静态图框架不同,MLX 的计算图是动态构建的。你改一个函数参数的形状,不会触发重新编译。
调试时,你可以逐行执行,随时查看中间结果。这对快速迭代模型很有帮助。PyTorch 也采用动态图,但 MLX 在 Mac 上结合统一内存,体验更流畅。
MLX 第一次怎么用:安装、建数组、跑模型
从安装到训练模型,流程很直接。
- 安装 MLX:用 pip 一行命令。
- 导入库:在 Python 脚本中
import mlx.core as mx。 - 创建数组:用
mx.array()或类似 NumPy 的函数。 - 执行操作:数组运算自动利用惰性计算和自动微分。
- 构建模型:用
mlx.nn定义网络结构。 - 训练与优化:用
mlx.optimizers和训练循环。 - 保存与加载:用
mx.save和mx.load。
安装 MLX:一行 pip 命令
安装很简单。在终端运行 pip install mlx 即可。需要 macOS 13.3 以上,且是 Apple Silicon 芯片。
没有复杂的依赖。安装后直接导入就能用。
创建数组与执行操作:NumPy 风格上手
创建数组和 NumPy 几乎一样。例如 mx.array([1, 2, 3]) 或 mx.zeros((2, 3))。
操作也类似。mx.add(a, b)、mx.matmul(a, b) 等。但底层是惰性计算,结果在需要时才生成。
构建与训练模型:用 mlx.nn 和 optimizers
mlx.nn 提供类似 PyTorch 的模块接口。你可以定义 nn.Linear、nn.Conv2d 等层。
mlx.optimizers 提供 Adam、SGD 等优化器。训练循环需要手动编写,但代码量不大。
MLX 与主流工具对比:PyTorch 和 JAX 差在哪
在 Mac 上,MLX 的直接对手是 PyTorch 和 JAX。三者各有侧重。
| 特性维度 | 统一内存 | API 熟悉度 | 动态图 | 生态成熟度 | Mac 优化 |
|---|---|---|---|---|---|
| MLX | ✓ | NumPy 风格 | ✓ | 较弱 | 深度优化 |
| PyTorch | ✗ | 自成一派 | ✓ | 强 | 一般 |
| JAX | ✗ | NumPy 风格 | 部分 | 中等 | 一般 |
关键在于统一内存。PyTorch 和 JAX 在 Mac 上仍需要显存拷贝,MLX 则省去这一步。
统一内存 vs 显存拷贝:MLX 与 PyTorch 的核心差异
PyTorch 在 Mac 上使用 MPS 后端时,数据仍要在 CPU 和 GPU 之间拷贝。MLX 的数组存在共享内存中,操作无需移动数据。
这带来两个实际好处:训练速度更快,内存占用更低。尤其对大模型,差异更明显。
生态成熟度:PyTorch 的库更多,MLX 在追赶
PyTorch 有庞大的第三方库和预训练模型。MLX 的生态还小,但正在增长。
目前 MLX 有 mlx-lm、mlx-vlm 等官方接口,以及 LM Studio 等第三方工具。但与 PyTorch 相比,模型数量和社区支持仍有差距。
MLX 真实用户案例:训练、推理、科研
- 本地大模型推理:通过 LM Studio 或 mlx-engine 运行 LLM。
- 图像与视频处理:目标检测、行为识别等计算机视觉任务。
- 科学研究:物理模拟、分子动力学、基因序列分析。
- 数据分析:高效处理大规模数据集。
这些场景都受益于统一内存和惰性计算。
本地大模型推理:LM Studio 与 mlx-engine
LM Studio 是流行的本地模型运行工具。它的 MLX 后端基于 mlx-engine,针对 Apple 芯片优化。
mlx-engine v1.8.5 通过 KV 缓存检查点,显著提升重复长上下文场景的性能。基准测试显示,并行聊天吞吐量提升 2.2 倍,长提示内存占用降低 82%。
图像与视频处理:目标检测与行为识别
MLX 可用于构建图像分类和视频分析模型。目标检测、行为识别等任务都能在 Mac 上高效运行。
统一内存让大尺寸图像和视频数据无需频繁拷贝,处理速度更快。
MLX 用户价值:训练速度与内存占用的实际收益
MLX 的核心价值在于效率。统一内存减少数据搬运,惰性计算降低内存占用。
- 训练速度:省去 CPU/GPU 拷贝,迭代更快。
- 内存占用:惰性计算避免中间数组,KV 缓存优化进一步降低。
- 易用性:NumPy 风格 API,学习成本低。
训练速度提升:统一内存减少数据搬运
传统框架中,每个训练步骤都要在 CPU 和 GPU 之间传输数据。MLX 没有这一步。
数据留在共享内存里,操作直接在设备上执行。这缩短了每个迭代的时间,尤其对数据密集型任务。
内存占用降低:惰性计算与 KV 缓存优化
惰性计算意味着数组只在需要时创建。这避免了不必要的中间结果存储。
在 LLM 推理中,KV 缓存是内存大户。mlx-engine v1.8.5 的磁盘缓存方案,让长提示内存占用降低 82%。
MLX 的更新频率:从 v1.8.5 看迭代节奏
MLX 相关生态更新活跃。近期 mlx-engine 和量化方案都有重要进展。
- mlx-engine v1.8.5:KV 缓存检查点,持续批处理。
- JANG 量化:2-bit 混合精度跑 230B 模型。
- MLX Studio:桌面端集成应用。
mlx-engine v1.8.5:KV 缓存检查点与持续批处理
LM Studio 发布的 mlx-engine v1.8.5 带来两个关键更新。
一是 KV 缓存检查点,让重复长上下文工作流性能大幅提升。二是 VLM 请求的持续批处理,图像请求处理速度提升 3.5 倍。
JANG 量化方案:2-bit 混合精度跑 230B 模型
JANG 被称为“MLX 的 GGUF”。它采用混合精度量化,不同层给不同精度。
以 230B 参数的 MiniMax M2.5 为例:MLX 4-bit 只有 26.5% MMLU,而 JANG 2-bit 混合达到 74%,体积还更小。
MLX 总体评价:适合谁,不适合谁
MLX 是 Apple Silicon 上机器学习的有力选择。但并非人人适用。
- 适合:Mac 用户、NumPy/PyTorch 经验者、本地推理需求。
- 不适合:需要庞大第三方库、跨平台部署、极致生态支持的用户。
推荐指数:Apple Silicon 开发者的优先选择
如果你在 Mac 上做机器学习,MLX 值得优先考虑。统一内存和惰性计算带来实际效率提升。
但如果你依赖大量 PyTorch 专属库,或需要跨平台训练,PyTorch 仍是更稳妥的选择。
MLX 集成生态:API、插件与第三方工具
MLX 的生态正在扩展。官方提供高级接口,第三方工具也在增加。
- mlx-lm:语言模型接口。
- mlx-vlm:视觉语言模型接口。
- LM Studio:桌面端推理应用。
- MLX Studio:另一款桌面应用。
mlx-lm 与 mlx-vlm:语言与视觉模型接口
mlx-lm 和 mlx-vlm 是官方提供的高级包。它们封装了模型加载、推理等常见操作。
用户无需从头编写模型代码,几行就能跑起 LLM 或 VLM。
LM Studio 与 MLX Studio:桌面端集成
LM Studio 是流行的本地模型工具,其 MLX 后端基于 mlx-engine。MLX Studio 则提供更友好的界面。
这些工具让非技术用户也能在 Mac 上运行大模型。