Caffe 是什么:定位和人群
从伯克利实验室走出的框架
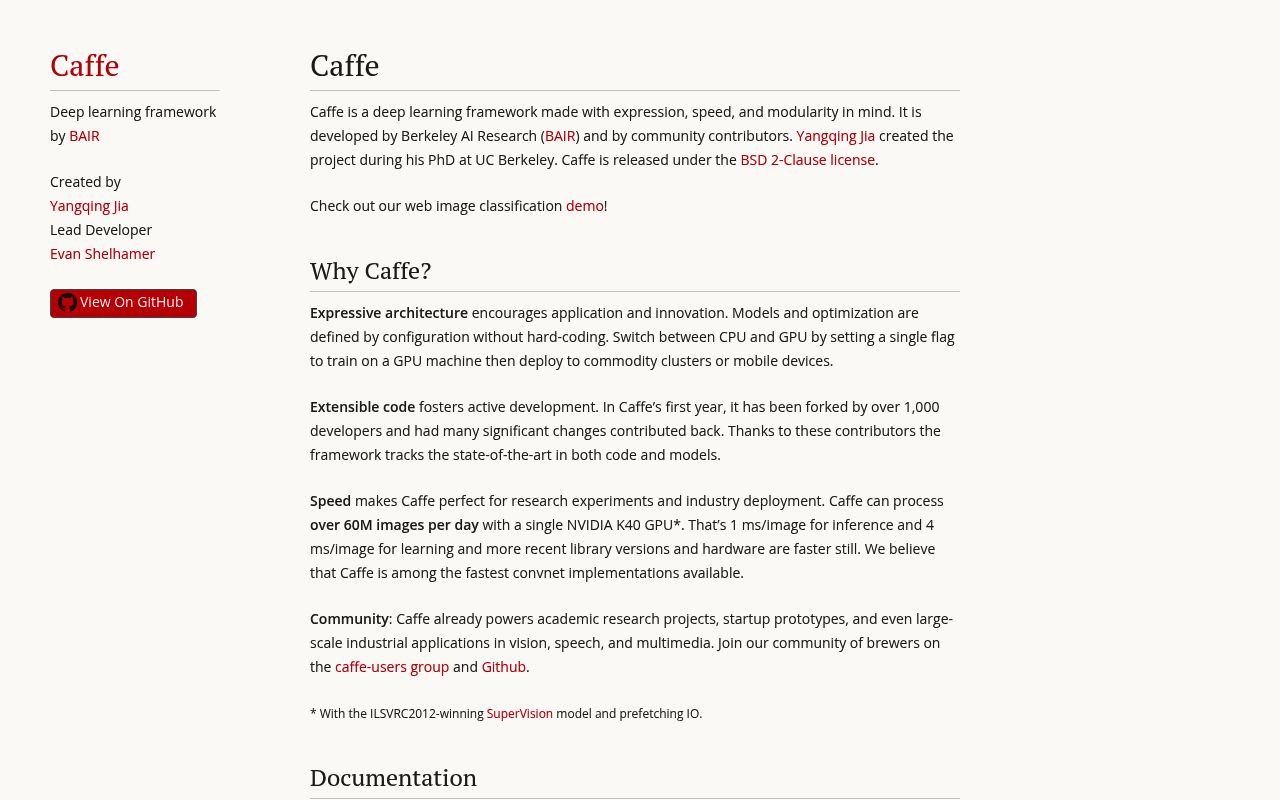
Caffe(全称 Convolutional Architecture for Fast Feature Embedding,快速特征嵌入的卷积架构)是加州大学伯克利分校视觉与学习中心(BVLC)开发的深度学习框架。作者贾扬清在博士期间创建了这个项目,2013 年开源后迅速流行。2013 到 2017 年间,该框架是计算机视觉领域的主流选择之一。大量学术论文用它复现实验,工业界也用它部署图像识别系统。官网显示,项目第一年就被超过 1000 名开发者分叉,社区贡献了大量改进。
它解决什么痛点
传统深度学习开发需要手写大量代码来定义网络结构。该框架改变了这一点。你用配置文件(prototxt)描述网络,无需硬编码。模型定义、优化设置、预训练权重都以文本形式给出。改配置就能换网络,不用重写 C++ 或 Python 代码。这降低了实验门槛,让研究者能快速试错。
适合谁用
- 学术研究者:需要复现 2013-2017 年的经典论文。
- 图像任务工程师:处理分类、检测、分割等视觉问题。
- 需要 C++ 部署的团队:模型可导出为 .caffemodel 文件,集成到生产环境。
- 追求训练速度的用户:在 GPU 上处理海量图像数据效率高。
Caffe 的卷积网络配置:核心能力拆解
用 prototxt 定义网络结构
prototxt 是该框架的核心配置文件格式。一个卷积层的定义包含四个关键字段:name(层名)、type(层类型,如 CONVOLUTION)、bottom(输入 blob 名)、top(输出 blob 名)。例如:
name: "conv1"
type: CONVOLUTION
bottom: "data"
top: "conv1"
convolution_param {
  num_output: 20
  kernel_size: 5
  stride: 1
}
这段配置定义了一个输出 20 通道、卷积核 5×5、步长 1 的卷积层。你不需要写任何前向传播代码。
Blob 与 Layer 的数据流
Blob 是数据存储的基本单元。图像数据格式为四维:数量×通道数×高×宽。卷积权重格式为:卷积核数量×卷积核通道数×卷积核高×卷积核宽。偏置格式为:偏置数目×1×1×1。每个 Blob 包含 data(原始数据)和 diff(梯度)两个指针。Layer 是计算单元,每个层实现 forward(前向计算)和 backward(反向传播)两个函数。数据在层间以 Blob 形式流动。
Solver 控制训练过程
Solver 封装了优化算法、学习率策略和迭代次数。你可以在 solver.prototxt 中指定:
- 优化算法:SGD、Momentum、Nesterov、Adagrad 等。
- 学习率策略:fixed、step、inv、multistep 等。
- 最大迭代次数:max_iter。
- 快照间隔:snapshot,定期保存模型。
Solver 还开放了更新参数的接口,你可以继承它实现自定义优化方法。
其他能力简览
该框架提供 Python 和 MATLAB 接口,方便数据预处理和后处理。社区维护的 Model Zoo 包含大量预训练模型,如 AlexNet、VGG、ResNet 等。它还内置神经网络可视化工具,帮助理解中间层输出。
Caffe 第一次怎么用:从安装到跑通 MNIST
安装依赖与编译
先装依赖:CUDA(GPU 计算平台)、cuDNN(深度神经网络加速库)、OpenCV(图像处理库)、BLAS(基础线性代数库)、Boost(C++ 工具库)、protobuf(数据序列化库)、glog、gflags、hdf5。在 Ubuntu 上执行:
sudo apt-get install libprotobuf-dev libleveldb-dev libsnappy-dev libopencv-dev libhdf5-serial-dev protobuf-compiler
sudo apt-get install --no-install-recommends libboost-all-dev
然后编译:
make all
make test
make runtest
准备数据与生成 LMDB
MNIST 数据集可从官网下载。图片需转成 LMDB(内存映射数据库)格式。用 convert_imageset 工具:
./build/tools/convert_imageset mnist_train/ train.txt mnist_train_lmdb
train.txt 每行包含图片路径和标签。转换后生成 LMDB 文件夹,供数据层读取。
编写 prototxt 并启动训练
写两个文件:train.prototxt(网络结构)和 solver.prototxt(训练参数)。然后执行:
./build/tools/caffe train --solver=solver.prototxt
训练开始后,终端会输出 loss 和 accuracy。模型定期保存为 .caffemodel 文件。
Caffe 和类似工具怎么选:与 PyTorch、TensorFlow 对比
Caffe vs PyTorch
PyTorch 使用动态图,代码即模型,调试方便。该框架使用静态配置文件,调试时看不到中间变量。PyTorch 社区活跃度远高于该框架。但该框架在 C++ 部署和训练速度上仍有优势。
Caffe vs TensorFlow
TensorFlow 支持移动端和嵌入式设备,部署灵活。该框架主要面向服务器端 GPU 环境。TensorFlow 学习曲线陡峭,该框架配置文件方式更直观。但 TensorFlow 对 RNN 支持更好。
什么时候选 Caffe
- 复现 2013-2017 年的老论文,代码基于该框架。
- 需要 C++ 部署,不想引入 Python 运行时。
- 追求极致训练速度,图像任务为主。
- 团队已积累大量 prototxt 配置和 .caffemodel 模型。
| 比较维度 | Caffe | PyTorch | TensorFlow |
|---|---|---|---|
| 图模式 | 静态配置文件 | 动态图 | 静态图+动态图 |
| 调试体验 | 较差,看不到中间变量 | 好,直接打印张量 | 一般,需用 tf.print |
| 社区活跃度 | 低,更新缓慢 | 高,学术界主流 | 中,工业界广泛 |
| 移动端支持 | 弱 | 一般 | 强 |
| 学习曲线 | 平缓(配置文件) | 平缓(Pythonic) | 陡峭(API 复杂) |
Caffe 用户实际体验:三个典型场景
图像分类
下载 AlexNet 或 VGG 预训练模型,替换最后一层全连接层,微调新数据集。改 train.prototxt 中的 num_output 为你的类别数。用预训练权重初始化,学习率设为 0.001。训练几小时即可得到不错精度。
目标检测
基于 R-CNN 或 Fast R-CNN 流程。先用 Selective Search 提取候选区域,再用该框架提取 CNN 特征,最后训练 SVM 分类器。Fast R-CNN 把整个流程整合进网络,端到端训练。该框架是这些经典检测算法的官方实现框架。
特征提取
用中间层输出做图像检索或相似度计算。例如,取 fc7 层 4096 维向量作为图像特征。用 Python 接口加载模型,前向传播一次,提取特征。然后计算余弦相似度。这种方法在 2014-2016 年很流行。
Caffe 节省时间和精力:具体收益
训练速度的量化数据
该框架与 cuDNN 结合,测试 AlexNet 模型,在 K40 GPU 上处理每张图片只需 1.17ms。官网称,使用单块 NVIDIA K40 GPU,一天内可以完成 ImageNet 数据集的训练。这个速度在 2014 年非常突出。
配置复用与快速实验
改配置文件就能换网络结构。例如,把卷积层 kernel_size 从 5 改成 3,或把 pool 层从 max 改成 average。不用重写代码。这大幅缩短了实验周期。你可以快速尝试不同网络变体,找到更适合任务的结构。
Caffe 的最新动态:从 Caffe2 到 PyTorch 的迁移
Caffe2 的诞生与并入
2017 年 Facebook 发布 Caffe2,主打移动端和低功耗设备。2018 年,Caffe2 并入 PyTorch 项目。此后,原版该框架基本停止更新。官网仍可访问,但 GitHub 仓库活跃度很低。
对现有 Caffe 用户意味着什么
原版该框架仍可用,模型文件格式不变。但新项目建议转向 PyTorch。PyTorch 继承了 Caffe2 的移动端能力,同时提供动态图。老代码可以继续跑,但不要期待新功能。
Caffe 的优点和缺点:坦诚评估
三个突出优点
- 速度快:C++/CUDA 架构,GPU 利用率高。K40 上 AlexNet 每张 1.17ms。
- 配置文件清晰:网络结构、优化参数全部文本化,易读易改。
- 模块化易扩展:添加新层只需实现 forward 和 backward 函数。
两个明显缺点
- 对 RNN 支持差:递归网络和语言建模能力弱。
- 接口曾变动:早期版本更新导致旧代码不兼容。
Caffe 的学习曲线:上手难度与文档质量
上手难度
配置文件方式降低入门门槛。你不必懂 C++ 也能定义网络。但编译安装需要处理 CUDA、cuDNN 等依赖,可能劝退新手。建议先用预编译 Docker 镜像。
文档与社区资源
官网教程覆盖 MNIST、ImageNet 等经典任务。Model Zoo 提供大量预训练模型。GitHub issues 有历史讨论,但新问题响应慢。中文教程多集中在 2016-2018 年。
典型学习周期
从零到跑通 MNIST 大约需要 1-2 周。第一周装环境、编译、读文档。第二周写 prototxt、调参、跑通训练。有深度学习基础的人会更快。