NLTK 是什么:免费开源的 Python 文本处理工具包
NLTK(Natural Language Toolkit,自然语言工具包)是一套开源的 Python 模块、数据集和教程,专门用于自然语言处理(NLP)。它提供分词、词性标注、句法分析、命名实体识别等工具。与 spaCy 相比,NLTK 更侧重教学与学术研究,而非工业级性能。该工具包包含 50 多种语料库和词汇资源,例如 WordNet。根据官网 2024 年 8 月公开信息,它适用于 Windows、Mac OS X 和 Linux。
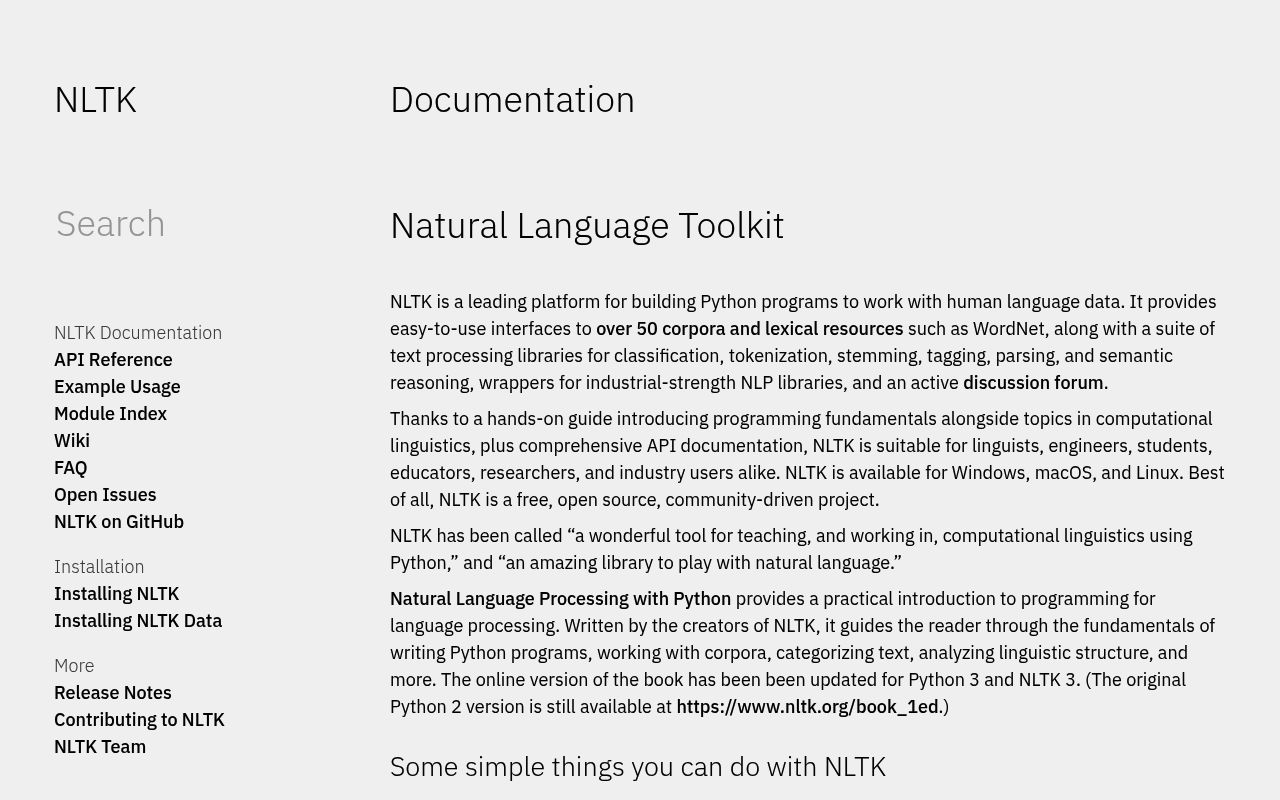
该工具完全免费,社区驱动。它支持 Python 3.7 至 3.11 版本。新手可以快速上手,研究者能调用底层算法。该工具包被广泛用于教育、学术和商业原型开发。
假设你刚接触自然语言处理
假设你刚接触自然语言处理,想弄懂“分词”是什么。NLTK 提供交互式教程和大量示例代码。你可以直接运行一行命令看到结果。
import nltk
nltk.download('punkt')
from nltk.tokenize import word_tokenize
text = "NLTK is a powerful library for natural language processing."
print(word_tokenize(text))
输出结果立刻展示单词切分逻辑。这种即时反馈降低了学习门槛。该工具包还附带一本免费在线书籍《Natural Language Processing with Python》。它把编程基础和计算语言学概念放在一起讲。
NLTK 主要功能一览:从分词到句法分析
NLTK 的功能覆盖 NLP 流程的多个核心环节。以下逐条列出关键能力与用途。
| 功能 | 用途 |
|---|---|
| 分词(Tokenization) | 把连续文本切成单词或句子,是预处理第一步 |
| 词性标注(Part-of-Speech Tagging) | 给每个词打上名词、动词等标签 |
| 命名实体识别(NER) | 识别文本中的人名、地名、组织名 |
| 词干提取(Stemming) | 用启发式规则把词还原为词干,如“running”变“run” |
| 词形还原(Lemmatization) | 依据词典和上下文还原词元,比词干提取更准确 |
| 句法分析(Parsing) | 生成句法树,展示词语间的修饰关系 |
| 语料库访问 | 内置 Brown 语料库、PENN Treebank 等资源 |
| 分类器 | 提供朴素贝叶斯、决策树等模型,用于文本分类 |
| 特征提取 | 从文本中抽取特征,供机器学习模型训练 |
分词与词性标注:文本预处理的第一步
假设你需要分析一条英文评论,第一步是分词。NLTK 的 word_tokenize 函数基于 punkt 模型。该模型通过无监督学习自动掌握句子和单词的分割规则。
from nltk import pos_tag
tagged = pos_tag(words)
print(tagged)
词性标注结果类似 [('I', 'PRP'), ('love', 'VBP'), ('natural', 'JJ')]。这为后续句法分析或情感分析打下基础。公开教程显示,这些操作只需几行代码。
命名实体识别与句法分析:提取结构化信息
如果需要从新闻文本中提取公司名,命名实体识别能帮忙。NLTK 需要下载 maxent_ne_chunker 模型。它基于最大熵算法。
句法分析则生成树状结构。例如“NLTK is powerful”会被解析为主语加谓语。这种结构信息对构建问答系统很有用。你可以看到每个词在句子中的语法角色。
怎么用 NLTK:从安装到第一个分词程序
安装和使用 NLTK 只需三步。第一步安装库,第二步下载数据包,第三步运行代码。
安装 NLTK:一条命令搞定
在终端运行 pip install nltk。安装完成后,用以下代码验证版本:
import nltk
print(nltk.__version__)
如果输出 3.8 或更高版本号,说明安装成功。该工具包支持 Python 3.7 至 3.11。
下载数据包:punkt 和 averaged_perceptron_tagger
NLTK 的核心算法与数据分离。分词器 punkt 和词性标注器 averaged_perceptron_tagger 需要单独下载。
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
punkt 负责句子和单词切分。averaged_perceptron_tagger 基于感知器算法标注词性。没有这些数据包,相关函数会报错。
NLTK 对比主流替代品:spaCy 和 HanLP 怎么选
NLTK、spaCy 和 HanLP 是三个主流 NLP 工具包。选择取决于任务类型、语言和性能要求。
NLTK vs spaCy:教学优先还是性能优先
| 特性维度 | 设计目标 | 处理速度 | API 风格 | 中文支持 | 文档与教程 |
|---|---|---|---|---|---|
| NLTK | 教学与研究 | 较慢 | 函数式,模块分散 | 需额外配置 | 极其丰富 |
| spaCy | 工业级应用 | 快,内存占用少 | 面向对象,流水线式 | 官方支持 | 相对较少 |
NLTK 适合学习 NLP 概念。spaCy 适合生产环境。公开资料显示,spaCy 的 API 设计更简洁,构建复杂流水线更容易。
NLTK vs HanLP:中文支持差异明显
HanLP 专注于中文及多语言处理。NLTK 的中文支持有限,需要额外下载语料和模型。
- 如果处理英文文本或做教学演示,NLTK 足够。
- 如果处理中文文本,HanLP 是更直接的选择。
- 如果追求速度,spaCy 更合适。
NLTK 真实用户案例:学术、教育和商业场景
NLTK 在多个领域有实际应用。以下列举典型场景。
假设你在做情感分析
假设你需要判断一条推文是正面还是负面。你可以用 NLTK 的朴素贝叶斯分类器。
from nltk.classify import NaiveBayesClassifier
# 准备标注数据,提取特征,训练模型
公开教程展示,先用分词和词性标注处理文本,再提取特征。最后训练分类器预测情感倾向。
假设你在构建问答系统
假设你想让程序回答“谁写了这本书?”这类问题。句法分析能识别主语和宾语。
NLTK 的句法树展示词语间的依存关系。你可以据此抽取答案片段。这种思路在早期问答系统中很常见。
NLTK 能带来什么好处:免费、全面、教学资源丰富
NLTK 的核心优势在于零成本、功能覆盖广、文档齐全。
- 免费:完全开源,无需付费订阅。
- 全面:覆盖从分词到语义推理的多种任务。
- 教学资源:附带免费书籍、教程和活跃论坛。
对于学生和研究者,这些资源降低了入门门槛。对于商业原型,它能快速验证想法。
NLTK 版本变化:3.8 稳定版与 Python 3.11 兼容
截至 2024 年 8 月,NLTK 的稳定版本是 3.8。它兼容 Python 3.7 至 3.11。GitHub 仓库显示有 12,044 次提交,社区持续维护。
该版本修复了旧版的一些问题,并保持 API 稳定。升级时只需运行 pip install –upgrade nltk。
NLTK 总体评价:适合谁,不适合谁
NLTK 适合 NLP 初学者、语言学家、教育工作者和研究人员。它不适合需要处理大规模数据或追求极致性能的工业场景。
推荐指数:教学场景 5/5,生产环境 2/5。如果你只想快速上手 NLP,它是很好的起点。
NLTK 国内可用性:访问、中文界面与支付
NLTK 官网和 GitHub 在国内可以访问,但下载数据包可能需要代理。数据包托管在境外服务器。
该工具包没有中文界面,文档和教程以英文为主。它完全免费,不涉及支付。国内用户主要面临网络延迟问题。
NLTK 行业地位:学术界的经典工具
NLTK 自 2001 年推出,是 Python 社区最早的 NLP 库之一。它被称为“使用 Python 进行计算语言学教学和工作的绝佳工具”。
大量学术论文和课程使用它作为教学工具。其语料库和算法实现成为许多后续工具的基础。
NLTK 底层模型技术栈:规则与统计方法结合
NLTK 混合使用规则引擎和统计模型。分词器 punkt 基于无监督学习。词性标注器 averaged_perceptron_tagger 基于感知器算法。
命名实体识别使用最大熵模型。分类器支持朴素贝叶斯、决策树、条件随机场等。这种多样性让用户能理解不同算法的原理。
参考资料
- www.nltk.org(2024-08-19)— NLTK 官网,提供功能概述和平台定位。
- CSDN(2024-08-08)— 介绍 NLTK 的核心特征、算法与模型。
- GitHub(2024-12-06)— NLTK 源码仓库,展示提交历史和版本状态。
- 知乎(2019-07-31)— 分享 NLTK 基本功能与代码示例。