Evidently AI 工具定位是什么
模型上线后,数据分布一旦变化,性能就会悄悄下降。传统软件测试查不出这种问题。Evidently AI 是一个开源 Python 库,专门做机器学习模型监测和测试。它解决的核心难题是:模型在生产环境里跑着跑着就不准了,但没人知道为什么。
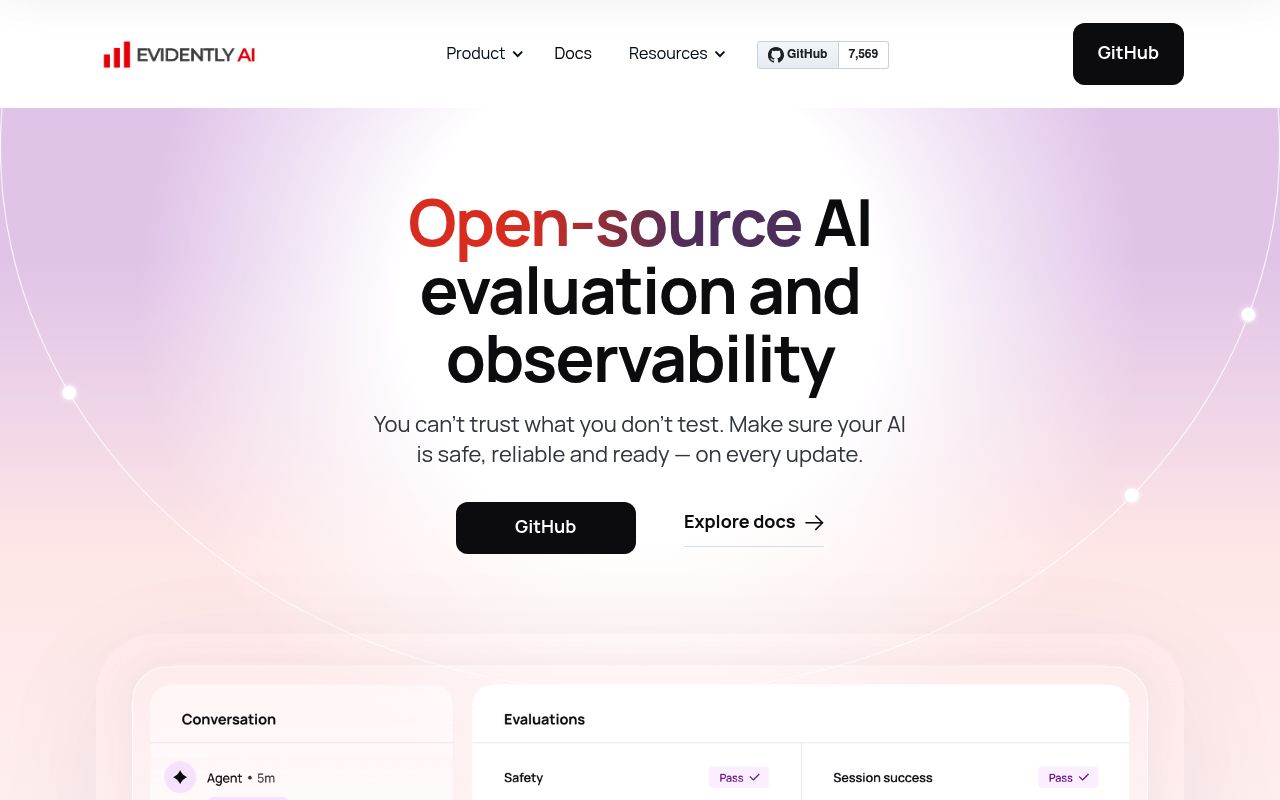
这个工具从 pandas DataFrame(Python 里常用的表格数据结构)直接生成交互式可视化报告。你不需要把数据上传到任何外部服务器。报告在本地生成,打开浏览器就能看。和同类工具比,它最大的不同是输出形式。很多监测工具只给一串数字指标,而 Evidently AI 给出的是带图表的完整报告。漂移分数、特征分布变化、混淆矩阵,全都直观呈现。
根据官网公开信息,该工具提供 100 多个现成指标,覆盖数据漂移、分类性能、回归性能等场景。它的开源属性意味着你可以免费使用,也可以查看源码。对于需要合规审计的团队,本地生成报告这一点尤其重要。数据不离开你的环境。
Evidently AI 主要功能的实际表现
这个工具的核心功能围绕“模型上线后会发生什么”展开。它不帮你训练模型,而是帮你盯住已经上线的模型。
- 数据漂移检测:比较参考数据和当前数据的特征分布。输出漂移分数,以及每个特征的分布变化图。常用指标包括 PSI(群体稳定性指数,衡量分布差异的常用值)。
- 分类模型性能报告:计算准确率、召回率、精确度、F1 分数。同时生成混淆矩阵、ROC 曲线(受试者工作特征曲线,展示模型区分能力)、PR 曲线(精确率-召回率曲线)。
- 数值目标漂移:针对回归任务,检测预测目标或数值特征是否发生漂移。
- 回归模型性能报告:输出 MAE(平均绝对误差)、RMSE(均方根误差)等回归指标。
100 多个指标不是一次全用上。你按需选择,添加到报告对象里。报告类型目前有 6 种。每种报告对应一个特定监测场景。这种模块化设计让上手成本降低。你不需要理解所有指标才能开始。
数据漂移检测:从 Pandas DataFrame 到报告
数据漂移检测是这个工具最突出的能力。流程很直接。你准备两份数据:参考数据(通常是训练集或上线初期的数据)和当前数据(新产生的生产数据)。两份数据都是 pandas DataFrame 格式。
然后调用 Report 对象,添加数据漂移指标。运行后,工具会计算每个特征的分布变化。结果是一份 HTML 报告。报告里包含漂移分数、特征重要性排序、分布对比图。你一眼就能看出哪个特征变化最大。
漂移分数通常基于统计检验或距离度量。具体算法可以在文档里查到。报告中的图表是交互式的。你可以悬停查看具体数值,也可以缩放查看分布细节。
分类模型性能报告:混淆矩阵与阈值分析
分类模型上线后,性能可能随着数据变化而波动。这个报告帮你持续跟踪。输入参考数据和当前数据,以及两边的真实标签和预测结果。工具会计算准确率、召回率、精确度、F1 分数这四项核心指标。
混淆矩阵用热力图展示。你能看到哪些类别容易混淆。ROC 曲线和 PR 曲线也包含在内。这些图表帮助判断模型是否需要重新训练。
阈值分析是这个报告的一个实用点。分类模型通常有一个决策阈值。不同阈值下,精确率和召回率会此消彼长。报告展示这种权衡关系。你可以根据业务需求选择合适的阈值。
怎么用 Evidently AI:从注册到上手
这个工具不需要注册账号。纯本地运行。你只需要 Python 环境。
- 安装 Python 库。
- 准备参考数据和当前数据。
- 生成报告。
- 查看交互式仪表板。
每一步都很短。下面两节详细说明。
安装与导入:一条 pip 命令
打开终端,运行:
pip install evidently
安装完成后,在 Python 脚本或 Jupyter Notebook 里导入:
from evidently.report import Report
from evidently.metric_preset import DataDriftPreset
然后准备数据。参考数据和当前数据都必须是 pandas DataFrame。列名要一致。
生成第一份数据漂移报告
用 Report 对象添加指标。数据漂移有预设指标,一行代码就能加上。
report = Report(metrics=[DataDriftPreset()])
report.run(reference_data=ref_df, current_data=cur_df)
report.save_html("drift_report.html")
运行这段代码,当前目录下会生成一个 HTML 文件。用浏览器打开,就能看到交互式报告。整个过程不需要联网。
Evidently AI 备选方案有哪些
市面上还有其他模型监测工具。各有侧重。下面比较三个常见选项。
| 比较维度 | Evidently AI | Deepchecks | whylogs |
|---|---|---|---|
| 开源/闭源 | 开源 | 开源 | 开源 |
| 报告类型 | 6 种 | 测试套件为主 | 数据画像为主 |
| 集成难度 | 低 | 中 | 低 |
| 可视化丰富度 | 高 | 中 | 低 |
Evidently AI 的突出点是报告类型多,可视化丰富。Deepchecks 更侧重测试套件,适合深度验证。whylogs 轻量,专注数据日志。
Deepchecks:侧重测试套件
Deepchecks 提供更丰富的测试套件。你可以定义很多检查条件,比如“特征 X 的 PSI 不得超过 0.2”。它更像一个测试框架。学习曲线比 Evidently AI 陡一些。你需要理解测试的概念。
whylogs:轻量级数据日志
whylogs 专注数据画像和日志。它把数据统计信息压缩成小的 profile。适合大规模数据流的轻量监测。但报告可视化不如 Evidently AI 丰富。它更多是数据层面的记录,不是面向模型的完整报告。
Evidently AI 用户实际体验
你会在这些场景中用到这个工具。
- 模型上线后监控数据漂移:定期跑报告,看特征分布是否变化。
- A/B 测试前后对比:比较不同版本模型的表现。
- 模型再训练触发:当漂移分数超过阈值,启动再训练流程。
- 合规审计报告:生成可存档的 HTML 报告,证明模型经过监测。
每个场景都围绕“模型上线后”这个时间点。训练阶段的评估不是它的重点。
上线后监控:设置漂移告警阈值
你可以写一个定时任务,每天或每周运行一次报告生成脚本。然后检查报告里的 PSI 值。
比如,设定规则:如果任何特征的 PSI 超过 0.2,就发送告警邮件。这个工具本身不提供告警功能。你需要自己写脚本读取报告结果。但报告里明确给出了每个特征的漂移分数,方便你设置阈值。
学习曲线:上手难度与文档质量
官方文档提供快速入门和示例笔记本。有 Python 基础的用户,通常 1 到 2 小时能生成第一份报告。API 设计简洁。核心对象只有 Report 和 TestSuite 两个。
你不需要理解所有指标。预设指标(Preset)让你一行代码添加一组常用监测。比如 DataDriftPreset 包含多个漂移相关指标。这种设计降低了学习成本。
文档质量中上。示例覆盖常见场景。但高级用法需要自己读源码或社区讨论。目前没有官方中文文档。英文阅读能力是隐性门槛。
Evidently AI 更新了哪些新东西
根据官网信息,这个工具近期转向 AI 产品测试栈。传统软件测试假设输出是确定的。AI 系统输出不确定,会以传统软件不会的方式出错。
新的方向是测量输出准确性、安全性和质量。生成清晰、可分享的报告,展示 AI 在哪里出错——精确到每个响应。同时支持创建真实、边缘案例和对抗性输入。从无害提示到恶意攻击。
从模型监测扩展到 AI 产品测试
官方平台新增了对 LLM(大语言模型)输出的评估。包括准确性、安全性、质量。还有对抗性输入测试。这意味着它不再局限于传统机器学习模型。
但要注意,这些新功能部分在云端平台提供,不一定全部开源。开源库仍然聚焦传统模型监测。如果你需要 LLM 评估,可能需要使用其商业平台。具体功能边界以官方文档为准。
这个工具的突出能力仍做不到的事
数据漂移检测很强,但它只能告诉你“数据变了”。它不能告诉你“为什么变”。根因分析需要你自己做。
它也不能自动修复模型。漂移报告给出信号,但再训练、特征工程、数据回填这些动作都要人工完成。
在 AI 产品测试的新方向上,开源部分和商业平台的边界还不清晰。如果你期待一个完全开源、覆盖 LLM 测试的解决方案,目前可能还达不到。
更广阔的市场趋势是:模型监测正在从“可选”变成“必需”。监管要求越来越严。企业需要证明模型是可靠的。Evidently AI 站在这个趋势的前沿,但它的开源定位意味着商业支持有限。你得到的是工具,不是服务。