C-Eval 是什么:一把量中文大模型的尺子
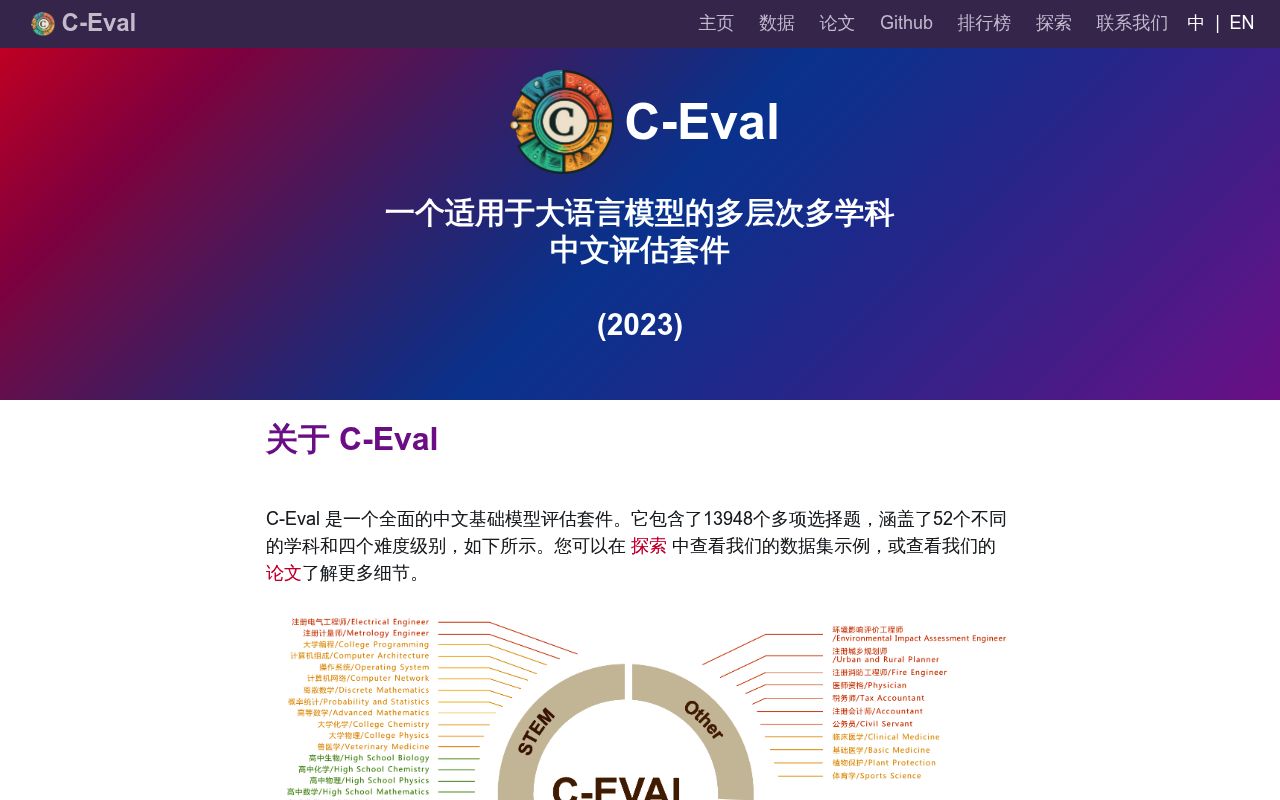
MMLU 是英文世界的通用标尺,C-Eval 则是中文语境下的对应物。该工具由上海交通大学、清华大学和爱丁堡大学联合推出,是一个中文基础模型评估套件。它包含 13948 道多选题,覆盖 52 个学科,分为四个难度级别。它的核心目标是检验大语言模型在中文环境下的高级知识与推理能力。
假设你刚训练完一个中文大模型
假设你刚训练完一个中文大模型,你想知道它到底有多强。靠人工感觉太主观,靠几个对话样本太少。你需要一把标准化的尺子,C-Eval 就是这把尺子。它用 13948 道题测模型,分数客观,可横向对比。
C-Eval 核心功能:52 个学科怎么考
该平台的核心功能围绕多学科覆盖、难度分级、标准化评测、防过拟合和排行榜展开。以下逐一说明。
- 多学科覆盖:题目横跨 STEM、社会科学、人文科学等 52 个学科,包括计算机、电气工程、化学、数学、物理、政治、地理、教育学、经济学、工商管理、法律、艺术、逻辑学、语文、历史、环境、消防、税务、体育、医学等。这种广度确保评估全面。
- 难度分级:分为初中、高中、大学、专业四个级别。研究者可以看到模型在不同知识难度阶梯上的具体表现。
- 标准化评测:全部采用客观选择题形式,避免主观评判干扰。支持零样本和少样本两种评估模式。
- 防过拟合设计:题目来自非公开来源,避免使用网络常见真题。这降低模型因"刷题"而过拟合的风险。
- 公开排行榜:用户提交模型预测结果,系统自动计算分数并更新排名。社区机制促进模型迭代。
四档难度:从初中到专业
初中难度适合验证基础常识,高中难度涉及更多学科知识。大学难度考察专业基础,专业难度对应高级推理。C-Eval Hard 子集包含需要高级推理能力的挑战性科目。根据官方论文,只有 GPT-4 的平均准确率超过 60%,这说明当前模型还有很大改进空间。
防过拟合:题目不来自公开真题
很多公开题库被模型反复训练过,模型可能靠记忆而非推理得分。该平台特意选用非公开来源的试题,题目主要来自模拟考试,减少数据泄漏风险。这样评估结果更能反映模型的泛化能力。
C-Eval 怎么用:从下载到提交排行榜
使用流程包括数据下载、选择评估模式、准备模型、构建提示、生成回答、评估模型和提交结果。
下载数据:Hugging Face 一行命令
用 datasets 库加载 ceval-exam 数据集:
from datasets import load_dataset
dataset = load_dataset("ceval/ceval-exam", name="computer_network")
或者直接下载 ZIP 文件并解压:
wget https://huggingface.co/datasets/ceval/ceval-exam/resolve/main/ceval-exam.zip
unzip ceval-exam.zip
选择零样本还是少样本
零样本模式下,模型没有任何示例直接回答问题。少样本模式下,模型在少量示例(如 5 个)的提示下回答问题。假设你要快速摸底模型能力,用零样本。如果需要更稳定的表现,用少样本。
C-Eval 对比主流替代品:MMLU 之外的选择
| 特性维度 | 语言 | 学科数量 | 题目数量 | 难度分级 | 防过拟合 |
|---|---|---|---|---|---|
| C-Eval | 中文 | 52 | 13948 | 4 级 | 非公开来源 |
| MMLU | 英文 | 57 | 14042 | 无明确分级 | 公开来源 |
| AGIEval | 中文 | 20+ | 约 8000 | 考试导向 | 公开来源 |
| SuperCLUE | 中文 | 10+ | 约 3000 | 无明确分级 | 公开来源 |
MMLU:英文世界的通用标尺
MMLU 覆盖 57 个学科,约 14042 道题。它是英文基准,无法准确衡量中文模型的中文能力。中文模型需要中文原生评测,该平台填补了这个空白。
AGIEval:更偏考试与逻辑
AGIEval 的题目多来自中国高考、公务员考试等公开考试,更侧重考试逻辑和应试能力。该平台则覆盖更广泛的学科,并包含更难的 Hard 子集。
C-Eval 典型应用场景:谁在用它
- 模型开发:开发者在迭代过程中跟踪模型版本间的能力变化。
- 学术研究:研究人员用该平台作为论文实验的对比基准。
- 教育评估:用于评估学生的学习成果,尤其在 STEM 领域。
- 行业优化:在金融、医疗、客服等行业评估和优化模型的领域知识。
- 社区竞赛:作为开放平台,为模型竞赛提供公平的基准测试工具。
模型开发:迭代时看分数变化
假设你训练了一个新版本模型,你想知道它比上一版强多少。用该平台跑一遍验证集,对比两次的准确率。分数提升说明迭代有效。
学术研究:论文里的标准基线
研究人员在论文中报告模型在该平台上的得分,这成为中文模型能力的标准基线。审稿人和读者可以横向比较不同模型。
C-Eval 帮你提升什么:具体收益
- 量化评估:用准确率等指标量化模型能力,而非主观感觉。
- 横向对比:通过排行榜对比不同模型,找到差距。
- 发现短板:分学科得分揭示模型的知识盲区。
- 指导优化:根据短板针对性补充训练数据。
发现模型在哪个学科最弱
假设你的模型在化学得分 45%,在历史得分 80%。这说明模型在化学领域知识薄弱,你可以针对性补充化学数据。重新训练后再次评估,看化学得分是否提升。
C-Eval 的优点和缺点:不吹不黑
优点:
- 全面:覆盖 52 个学科,四个难度级别。
- 防过拟合:非公开来源试题,降低刷题风险。
- 开源:数据集和评测工具开源,社区可参与。
- 标准化:客观选择题,评分可靠可比。
- 社区驱动:公开排行榜促进良性竞争。
缺点:
- 只有选择题:无法评估开放式生成能力。
- 中文限定:无法评估模型在其他语言上的表现。
- 静态题库:题库更新速度可能跟不上模型发展。
优点:标准化和社区驱动
标准化评分让不同模型的结果可比,公开排行榜让研究者看到最新进展。社区提交结果,系统自动更新排名,这促进了模型迭代。
缺点:只有选择题,测不了生成能力
假设你想评估模型的对话能力,该平台无法测。它只有选择题,测不了开放式生成、代码生成、创意写作等能力。
C-Eval 国内可用性:访问与提交
官网提供中文界面。数据下载渠道包括 Hugging Face 和直接下载 ZIP 文件。结果提交需登录官方平台。
官网和 Hugging Face 都能用
官网地址:https://cevalbenchmark.com/index_zh.html#home_zh。Hugging Face 数据集:ceval/ceval-exam。国内访问 Hugging Face 可能需要网络工具,官网访问通常正常。
C-Eval 版本变化:最近更新了什么
2023 年 9 月,排行榜优化了排列方式。评分划分为公众模型和非开放模型。题库和评测标准会持续扩充和迭代。
排行榜划分公众模型与非开放模型
据腾讯网 2023 年 9 月报道,该平台将评分划分为公众模型和非开放模型。这提高了榜单的透明度,用户可以更清楚地看到不同性质模型的表现。
底层模型技术栈:评测套件本身不是模型
该平台是一个评测数据集和工具,不是大语言模型。它基于自然语言处理技术构建,支持零样本和少样本推理。
它评测的是任何大模型,不分技术栈
该平台可以评测 GPT、ChatGLM、LLaMA 等不同架构的模型。它只关心模型在选择题上的表现,模型内部技术栈不影响评测。
什么时候升级到 C-Eval Hard 才值得
先用标准集跑通流程。如果基础集得分超过 60%,再考虑挑战 Hard 子集。Hard 子集包含高级推理题,能进一步区分模型能力。
先用标准集跑通,再挑战 Hard
假设你的模型在标准集得分 65%,这说明模型已经具备一定基础,此时挑战 Hard 子集才有意义。如果标准集得分低于 50%,先优化基础能力。