SuperCLUE 是什么:卖点和不足
SuperCLUE 是中文大模型圈里一个绕不开的名字。它由 CLUE 团队推出,前身是 2019 年成立的中文语言理解测评基准 CLUE。这个背景让它在中文评测领域有天然的话语权。
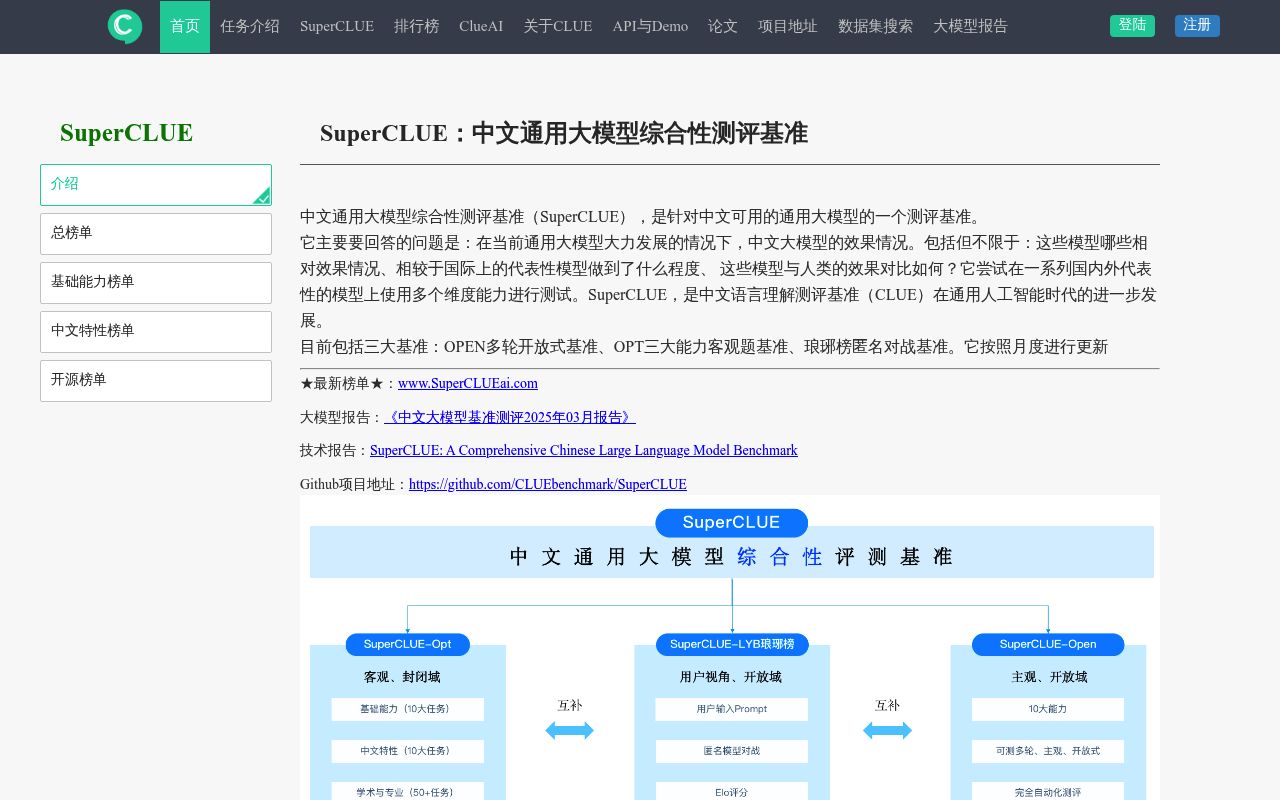
该工具的直接竞争对手是 OpenCompass 和 C-Eval。三者都做模型评测,但路线不同。SuperCLUE 强调「综合性」和「月度更新」,OpenCompass 偏重开源与社区共建,C-Eval 则聚焦学科知识。
核心卖点在于它的评测维度覆盖广。从语言理解到代码能力,再到安全性,共 12 项基础能力。它还支持与人类表现对比,这在国内评测里不多见。
不足也很明显。部分数据集未完全公开,评测成本较高。这影响了复现性和小团队的参与度。
SuperCLUE 的定位与核心卖点
SuperCLUE 定位为中文大模型综合性测评基准。它要回答的核心问题是:中文大模型到底行不行?哪些模型相对更好?和人类差距多大?
根据官方说明,该工具从四大能力象限评估模型:语言理解与生成、知识应用、专业技能、环境适应与安全性。这四大象限细化为 12 项基础能力。
一个关键设计是支持与人类表现对比。这让分数有了参照系。比如某模型在逻辑推理上得 60 分,人类基准可能是 80 分,差距一目了然。
该工具还新增了 AI Agent 智能体评估,重点测工具使用和任务规划。这紧跟了行业热点。
SuperCLUE 的主要不足
第一个不足是数据集公开性。GitHub 仓库里只有部分数据,完整评测集并未全部放出。这导致外部研究者很难完全复现结果。
第二个不足是评测成本。参与评测需要联系组织者,提交模型信息,等待运行测试。流程不透明,周期较长,对个人开发者不友好。
第三个不足是领域覆盖有限。虽然维度多,但每个维度下的题目数量有限。比如代码能力只有少量题目,难以反映真实工程表现。
SuperCLUE 实用功能
该工具的功能可以拆成五块,每块解决一个具体问题。
| 功能模块 | 具体说明 |
|---|---|
| 多维度能力评估 | 从语言理解、生成、知识应用、逻辑推理、代码能力、安全性等维度测试模型 |
| 多轮对话测试 | 评估模型在多轮对话中的连贯性和上下文理解能力 |
| 客观题与主观题结合 | 客观题量化基础能力,主观题评估创造性与灵活性 |
| 定期更新榜单 | 每月更新评测结果,展示不同模型的最新表现 |
| 提供技术报告 | 发布详细评测报告,分析模型优势与不足 |
多维度能力评估
该工具的评估维度覆盖 12 项基础能力,这些能力被归入四大象限。
| 能力象限 | 包含维度 |
|---|---|
| 语言理解与生成 | 语义理解与抽取、多轮对话、生成与创作 |
| 知识理解与应用 | 知识与百科、逻辑与推理、计算能力 |
| 专业能力 | 代码能力、AI Agent 智能体能力 |
| 环境适应与安全性 | 角色扮演、安全性 |
每个维度都有对应的测试题目。比如代码能力会考察模型理解和生成编程代码的能力,安全性会检测模型是否生成不当内容。
多轮对话与客观主观结合
多轮对话测试是该工具的特色之一。它评估模型在连续对话中能否保持连贯性,这比单轮问答更接近真实使用场景。
客观题与主观题结合是另一个设计亮点。客观题(如选择题)用于量化基础能力,主观题(如开放生成)用于评估创造性。
根据官方说明,主观题权重已提升至 60%。这反映了评测思路的转变:客观选择题不能完全反映真实综合能力。
榜单更新与技术报告
该工具每月更新榜单,这是它区别于 C-Eval 的重要特征。C-Eval 更新频率较低。
每次更新后,团队会发布技术报告。报告里包含各模型得分、排名变化、能力分析。比如 2024 年 11 月的报告显示,o1-preview 在 Hard 榜单上得分 14%,远超其他模型。
技术报告还提供模型象限图。横轴是能力,纵轴是成本,这帮助用户快速判断性价比。
SuperCLUE 怎么用:完整流程
使用该工具分三步:了解基准、准备模型、查看结果。
了解评测基准
访问官网或 GitHub 项目页面,阅读技术报告,熟悉评测维度和方法。
这一步很关键。不同评测基准的侧重点不同。比如 SuperCLUE 强调综合性,C-Eval 强调学科知识。选错基准,评测结果参考价值会打折扣。
准备模型并参与评测
确保模型可通过 API 交互,这是参与评测的前提条件。
然后通过官方邮箱联系组织者,提交模型信息,等待运行测试。
注意:该工具不提供自助提交平台,所有评测都由组织方统一运行。这保证了公平性,但也降低了效率。
查看评测结果
在 SuperCLUE 榜单查看结果。榜单按总分排名,也提供分项得分。
分析报告了解模型表现。报告会指出模型的优势和不足。比如某模型在代码能力上得分高,但在安全性上得分低。
类似于 SuperCLUE 的工具
SuperCLUE 不是唯一选择。OpenCompass 和 C-Eval 是另外两个主流中文评测基准,三者各有侧重。
SuperCLUE 与 OpenCompass 对比
| 比较维度 | SuperCLUE | OpenCompass |
|---|---|---|
| 评测维度 | 12 项基础能力,四大象限 | 更多细分任务,覆盖 50+ 数据集 |
| 更新频率 | 每月更新 | 不定期更新,随版本发布 |
| 数据集公开性 | 部分公开 | 完全公开 |
| 社区活跃度 | 中等,以官方发布为主 | 高,有活跃的开源社区 |
| 参与方式 | 联系组织者提交模型 | 可本地运行评测 |
OpenCompass 的优势在于开源和可复现。用户可以下载数据集和评测代码,在本地跑评测。SuperCLUE 则更依赖官方组织。
SuperCLUE 与 C-Eval 对比
| 比较维度 | SuperCLUE | C-Eval |
|---|---|---|
| 评测范围 | 综合能力,含对话、代码、安全 | 学科知识为主,覆盖 52 个学科 |
| 题目类型 | 客观题 + 主观题 | 选择题为主 |
| 适用模型 | 通用大模型 | 通用大模型,偏学术 |
| 结果呈现 | 月度榜单 + 技术报告 | 静态榜单,更新较慢 |
| 人类对比 | 支持 | 不支持 |
C-Eval 更像一场「大模型高考」,考的是学科知识。SuperCLUE 更像「综合能力体检」。两者适用场景不同。
SuperCLUE 典型应用场景
该工具的应用场景集中在五个方向。
- 模型性能评估:了解模型在多维度能力上的表现。
- 技术研究与优化:基于报告优化模型架构和训练方法。
- 行业应用开发:选择适合特定场景的模型。
- 学术研究比较:在同一标准下比较不同模型。
- 安全与合规性评估:检测模型生成内容的安全性。
模型性能评估
这是最直接的应用。研究人员和开发者可以用该工具了解模型在中文场景下的真实水平。
比如一个做客服机器人的团队,可以重点看多轮对话和安全性得分。一个做代码助手的团队,可以重点看代码能力得分。
技术研究与优化
评测报告提供详细的错误分析,这能帮助研究人员定位模型短板。
比如某模型在逻辑推理上得分低,报告会指出具体是哪种推理类型出错——是演绎推理还是归纳推理。这比笼统的「推理能力差」更有指导意义。
行业应用开发与学术比较
企业选型时,该工具的榜单可以作为参考。但要注意,榜单分数不等于实际业务效果。
学术比较方面,该工具提供标准化框架。不同机构的模型可以在同一标准下对比,这促进了技术交流。
安全与合规性评估
安全性是该工具的一个重要维度,它检测模型是否会生成不当内容。
这对企业用户尤其重要。一个在公开榜单上得分很高的模型,如果安全性不过关,上线后可能带来合规风险。
SuperCLUE 优势和不足
优势明显,不足也真实存在。
SuperCLUE 的具体收益
第一,提供全面性能基准。12 项能力覆盖了中文大模型的主要应用场景。
第二,标准化对比。所有模型在同一套题目下评测,结果可比性强。
第三,推动技术优化。技术报告中的错误分析为模型迭代提供了方向。
SuperCLUE 的局限性
第一,部分数据集未公开,这影响了评测的透明度和可复现性。
第二,评测成本较高。参与流程繁琐,对个人开发者不友好。
第三,对特定领域覆盖有限。比如医疗、法律等垂直领域,该工具的题目数量不足。
SuperCLUE 的更新频率
该工具保持月度更新,这是它的核心节奏。
月度榜单更新
每月发布新榜单,展示不同模型的最新表现。
比如 2026 年 5 月的榜单覆盖 21 款模型,包括六大任务:数学推理、科学推理、代码生成、智能体、精确指令遵循、幻觉控制,共 492 题。
新增 AI Agent 与 Terminal 测评
该工具在 2023 年 9 月新增了 AI Agent 智能体评估,重点测工具使用和任务规划。
2026 年 8 月,发布了 SuperCLUE-Terminal 中文智能体终端编程测评榜单。这是专门面向国内开发者的实战评测标准。
该榜单采用本土真实编程任务。每道题需要模型完成 50 至 110 轮交互,单题运行半小时到一个半小时。这比传统代码题更接近真实开发场景。
SuperCLUE 总体评价
SuperCLUE 是国内中文大模型评测的重要参考。它的月度更新和综合维度设计,让它成为行业风向标。
但它的局限性也不容忽视。数据集不透明、参与门槛高,限制了它的公信力。
对于需要快速了解模型综合能力的用户,该工具值得关注。对于需要深度定制评测或完全复现结果的用户,OpenCompass 可能更合适。
SuperCLUE 性价比分析
该工具本身是免费的。查看榜单和技术报告不需要付费。
但参与评测有隐性成本。你需要准备模型、联系组织者、等待排期,这些时间成本对小团队不低。
相比之下,OpenCompass 可以本地运行,成本更低。但 OpenCompass 的更新频率不如 SuperCLUE。
从 ROI 角度看,如果你只是查看榜单,SuperCLUE 的性价比很高。如果你要参与评测,需要评估时间投入是否值得。