CMMLU 定位和能做什么
CMMLU 是一个综合性的中文评估基准,用于衡量语言模型在中文语境下的知识和推理能力。它不是一个模型,也不是一个应用,而是一套测试题和评分标准。该基准覆盖 67 个主题,从基础学科到高级专业水平。主题范围包括需要计算和推理的自然科学、需要知识记忆的人文科学和社会科学,以及需要生活常识的中国驾驶规则等。许多任务具有中国特定的答案,在其他地区或语言中并不普遍适用。官方宣称它完全中国化,可作为英文基准的替代方案。但实际使用中,部分主题的题目数量偏少,可能影响评分的稳定性。
为什么中文模型需要一个独立基准
英文基准如 MMLU 覆盖 57 个学科,但缺少中国特定知识。例如,中国驾驶规则、中国历史、中国法律体系等,在英文基准中几乎不出现。CMMLU 填补了这一空白。它专门设计了中国特定答案的题目,比如交通标志含义、中国朝代顺序、中国行政区域划分。这些知识对中文用户很重要,但英文模型可能从未学习过。实际测试中,一个在 MMLU 上得分很高的英文模型,在 CMMLU 上可能大幅下降。这说明独立基准的必要性。
CMMLU 的 67 个主题分布
67 个主题大致分为几大类。自然科学类包括数学、物理、化学、生物等,这些主题需要计算和推理能力。人文社科类包括历史、文学、哲学、法律等,这些主题需要知识记忆能力。生活常识类包括中国驾驶规则、饮食文化、传统节日等。还有部分主题涉及中国特定政策,如计划生育、户籍制度。主题跨度大,但每个主题的题目数量不均衡。部分冷门主题可能只有几十道题,热门主题有几百道。这会影响细分结果的可靠性。
CMMLU 核心功能
该工具提供四项核心功能:排行榜、数据集、预处理代码、评估工具。排行榜展示不同模型在五样本和零样本测试下的表现。数据集提供开发和测试数据,支持快速使用。预处理代码提供提示生成方法,方便模型训练和测试。评估工具支持多种评估方式。官方宣称这些功能覆盖了评估全流程。但实际使用中,排行榜更新频率不稳定,部分提交结果可能长时间未验证。
排行榜:五样本与零样本双轨对比
排行榜同时展示五样本和零样本两种测试设置。五样本意味着每个问题前给模型五个示例,零样本则不给示例。五样本通常得分更高,因为模型可以从示例中学习格式。零样本更接近真实使用场景。双轨对比能揭示模型对示例的依赖程度。例如,某模型五样本得分 80%,零样本只有 60%,说明它依赖示例。排行榜按得分排序,但未提供置信区间。实际使用中,得分差异小于 1% 的模型可能没有显著区别。
数据集与预处理代码
数据集分为开发集和测试集。开发集用于调试模型,测试集用于正式评分。预处理代码在 src/mp_utils 目录中,运行 preprocess.py 可生成适合模型输入的格式。官方提供了提示生成方法,但具体模板未公开。实际使用中,不同模型可能需要不同的提示格式。预处理代码假设输入格式统一,可能不兼容所有模型。开发者需要自行修改代码。
评估工具支持多种方式
评估工具支持命令行运行,加载模型和 tokenizer 后执行测试脚本。研究者可灵活选择评估方式,适配不同模型。例如,可以只评估部分主题,或调整批处理大小。但官方文档对高级用法说明较少。实际使用中,遇到问题需要查看源码或提交 issue。
怎么用 CMMLU:从注册到上手
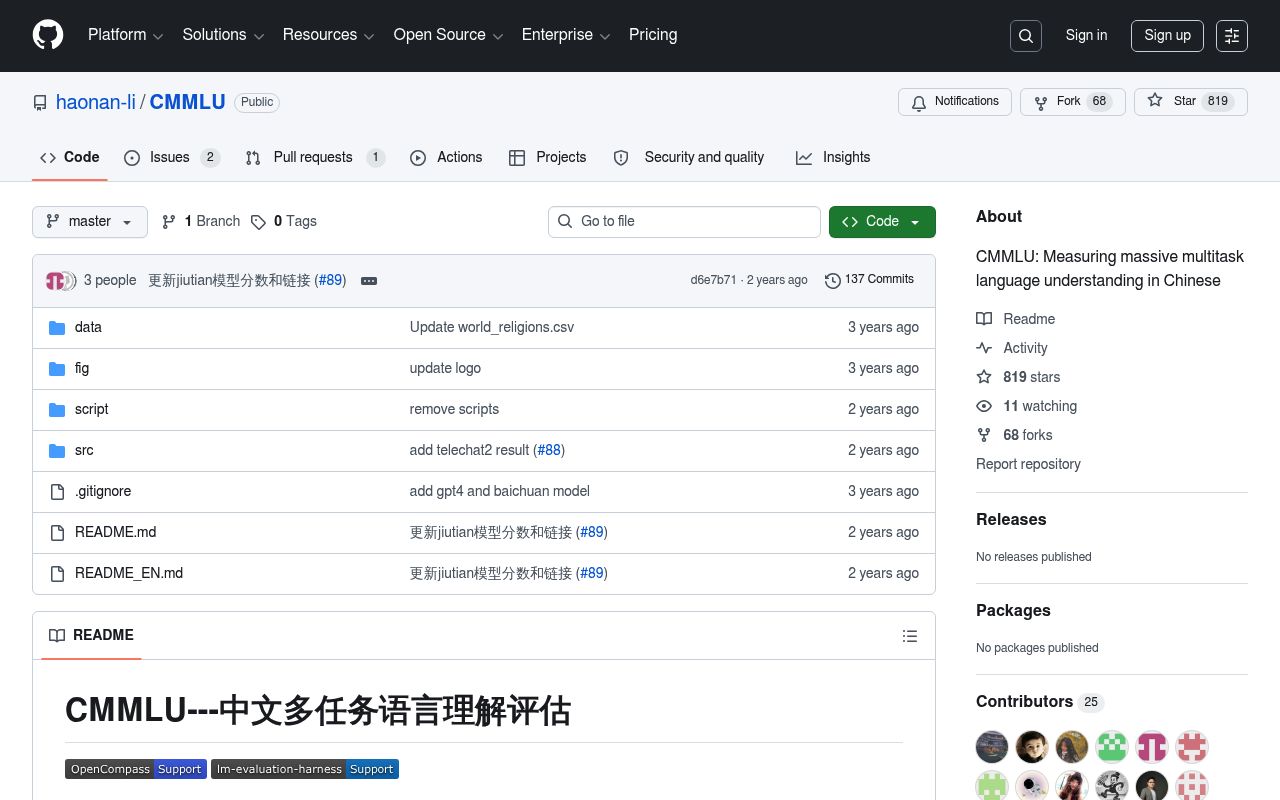
使用该工具不需要注册账号。直接从 GitHub 或 Hugging Face 获取数据集和代码。然后克隆仓库、安装依赖、预处理数据、运行评估脚本、提交结果。整个过程对熟悉 Python 的研究者来说比较直接。但对非技术用户,门槛较高。官方未提供图形界面或在线评测服务。
获取数据集:GitHub 与 Hugging Face
该工具提供两个获取渠道。GitHub 仓库地址是 https://github.com/haonan-li/CMMLU/,data 目录中有开发和测试数据集。Hugging Face 数据集地址是 https://huggingface.co/datasets/haonan-li/cmmlu,可用 datasets 库直接加载。两个渠道的数据内容一致。但 Hugging Face 加载更方便,适合快速试用。
环境准备与预处理
安装依赖包括 transformers、datasets 等 Python 库。克隆仓库后,进入 src/mp_utils 目录运行 preprocess.py。预处理脚本会生成模型输入格式。实际使用中,依赖版本冲突是常见问题。官方未提供 requirements.txt 锁定版本。用户需要自行解决环境问题。
运行评估与提交结果
运行 script/evaluate.py,指定模型名称和数据路径。评估完成后,开源模型可提交拉取请求更新排行榜。未开放模型需将结果发送到指定邮箱。官方宣称会验证结果后更新。但实际使用中,验证周期可能长达数周。提交前需自行检查格式,否则可能被拒绝。
CMMLU 同类工具横向比较
与 MMLU、C-Eval 相比,该工具的中国特定答案和 67 主题覆盖是主要差异。MMLU 是通用英文基准,C-Eval 是另一个中文基准。三者都采用多项选择题格式。但 CMMLU 的题目更贴近中国日常生活。
| 特性维度 | 主题数量 | 语言 | 中国特定知识 | 五样本/零样本 |
|---|---|---|---|---|
| CMMLU | 67 | 中文 | 有 | 支持 |
| MMLU | 57 | 英文 | 无 | 支持 |
| C-Eval | 52 | 中文 | 部分 | 支持 |
MMLU:通用知识基准的局限
MMLU 覆盖 57 个学科,是英文模型评测的常用基准。但它缺少中国特定知识。例如,中国法律、中国历史、中国地理等题目很少。一个在 MMLU 上得分 85% 的模型,可能在 CMMLU 上只有 60%。这说明英文基准不能完全替代中文基准。实际使用中,研发团队通常同时测试两个基准。
C-Eval:中文评测的另一选择
C-Eval 是另一个中文基准,覆盖 52 个学科。与 CMMLU 相比,C-Eval 的题目更偏向学术知识。CMMLU 则更强化中国文化、政策、教育体系。例如,CMMLU 有中国驾驶规则主题,C-Eval 没有。两者侧重点不同,不能简单说谁更好。实际使用中,团队可根据需求选择。
CMMLU 适合什么人用
典型用户包括语言模型研发团队、学术研究者、评测机构。应用场景包括教育辅导、智能客服、文化传播、医疗健康等。该工具适合需要量化中文模型能力的团队。但对个人开发者或非技术用户,使用门槛较高。
模型研发团队的迭代验证
研发团队用该工具测试模型在中文任务上的表现,优化架构。例如,在训练新模型后,运行 CMMLU 评估,对比上一版本得分。如果得分下降,说明新架构可能损害中文能力。实际使用中,团队通常将 CMMLU 纳入自动化测试流程。但评估耗时较长,可能拖慢迭代速度。
教育辅导与智能客服
教育辅导系统可利用该工具的多学科知识评估模型。例如,开发一个数学辅导模型,先测试其在 CMMLU 数学主题上的得分。智能客服优化也类似,评估模型在特定领域的知识理解能力。但该工具只提供选择题,无法评估生成式回答的质量。实际使用中,还需结合其他评测方法。
文化传播与医疗健康
文化传播场景可利用该工具的数据集开发文化问答系统。医疗健康场景可评估模型在医学领域的知识理解能力。但该工具的医学题目数量有限,可能不足以覆盖临床场景。实际使用中,医疗应用还需专业评测。
CMMLU 能带来什么好处
具体收益包括量化模型中文能力、发现知识盲区、支持模型选型。Qwen2.5 在 CMMLU 上得分 84.7%,是中文模型最高分之一。这个分数可作为参考。但单一分数不能全面反映模型能力。
量化中文能力:一个可比较的分数
CMMLU 分数可作为模型中文水平的统一度量。不同模型在同一套题上测试,得分可直接比较。例如,模型 A 得分 70%,模型 B 得分 80%,说明 B 的中文知识更扎实。但分数受题目分布影响,不能完全代表真实场景表现。实际使用中,应结合其他指标。
发现模型在特定主题的短板
通过 67 个主题的细分结果,可定位模型弱项。例如,某模型总分 75%,但中国历史主题只有 50%。这说明模型对中国历史知识掌握不足。研发团队可针对弱项补充训练数据。但细分结果的可靠性取决于题目数量。冷门主题的得分波动较大。
CMMLU 更新了哪些新东西
基于 GitHub 仓库动态,该工具增加了排行榜验证机制和数据污染检查。官方宣称会验证提交结果的指令跟随能力和数据污染情况。但具体验证方法未公开。实际使用中,验证流程的透明度有待提高。
排行榜验证与数据污染检查
官方对提交结果进行验证,防止数据污染。数据污染指模型在训练时见过测试题,导致得分虚高。验证机制包括检查模型是否在测试集上训练过。但该检查可能不全面。实际使用中,仍有模型通过污染获得高分。
CMMLU 集成生态
该工具提供预处理代码和评估脚本,可集成到模型训练流程。支持 Hugging Face 数据集加载。但官方未提供现成的 CI/CD 集成方案。用户需自行编写脚本。
Hugging Face 数据集加载
通过 datasets 库可直接加载 CMMLU 数据集。示例代码:load_dataset("haonan-li/cmmlu", "college_physics")。加载后可用 PyTorch 或 TensorFlow 处理。但数据集版本更新时,加载接口可能变化。实际使用中,需关注版本兼容性。
评估脚本与训练流程集成
评估脚本可嵌入模型开发循环,实现自动化测试。例如,在每次训练后自动运行评估,记录得分。但官方未提供现成的集成模板。用户需自行编写 CI 脚本。实际使用中,集成成本取决于团队工程能力。
CMMLU 适用人群画像
最适合需要中文能力验证的模型团队、学术研究者、评测机构。这些用户具备技术能力,能自行运行评估。对非技术用户,该工具的价值有限。
中文大模型研发团队
中文大模型研发团队需要中文基准来验证模型迭代效果。该工具提供了标准化的测试集和评分方法。团队可将其纳入模型发布前的必测项。但评估耗时较长,可能影响发布节奏。实际使用中,团队通常只测试部分主题。
学术研究者与评测机构
学术研究者和评测机构需要公开、可复现的评测标准。该工具的数据集和代码开源,结果可复现。但排行榜的验证机制不够透明,可能影响公信力。实际使用中,研究者可自行复现结果。
CMMLU 国内可用性
GitHub 和 Hugging Face 均可访问,数据集和代码开源,无支付要求。国内用户可通过这两个渠道获取资源。但 GitHub 访问速度可能不稳定。实际使用中,可考虑使用镜像或代理。
访问与使用门槛
国内用户可通过 GitHub 或 Hugging Face 获取资源。无支付要求,但需要一定的技术能力。非技术用户无法直接使用。实际使用中,建议具备 Python 基础。