华为Flex:ai是什么:卖点和不足
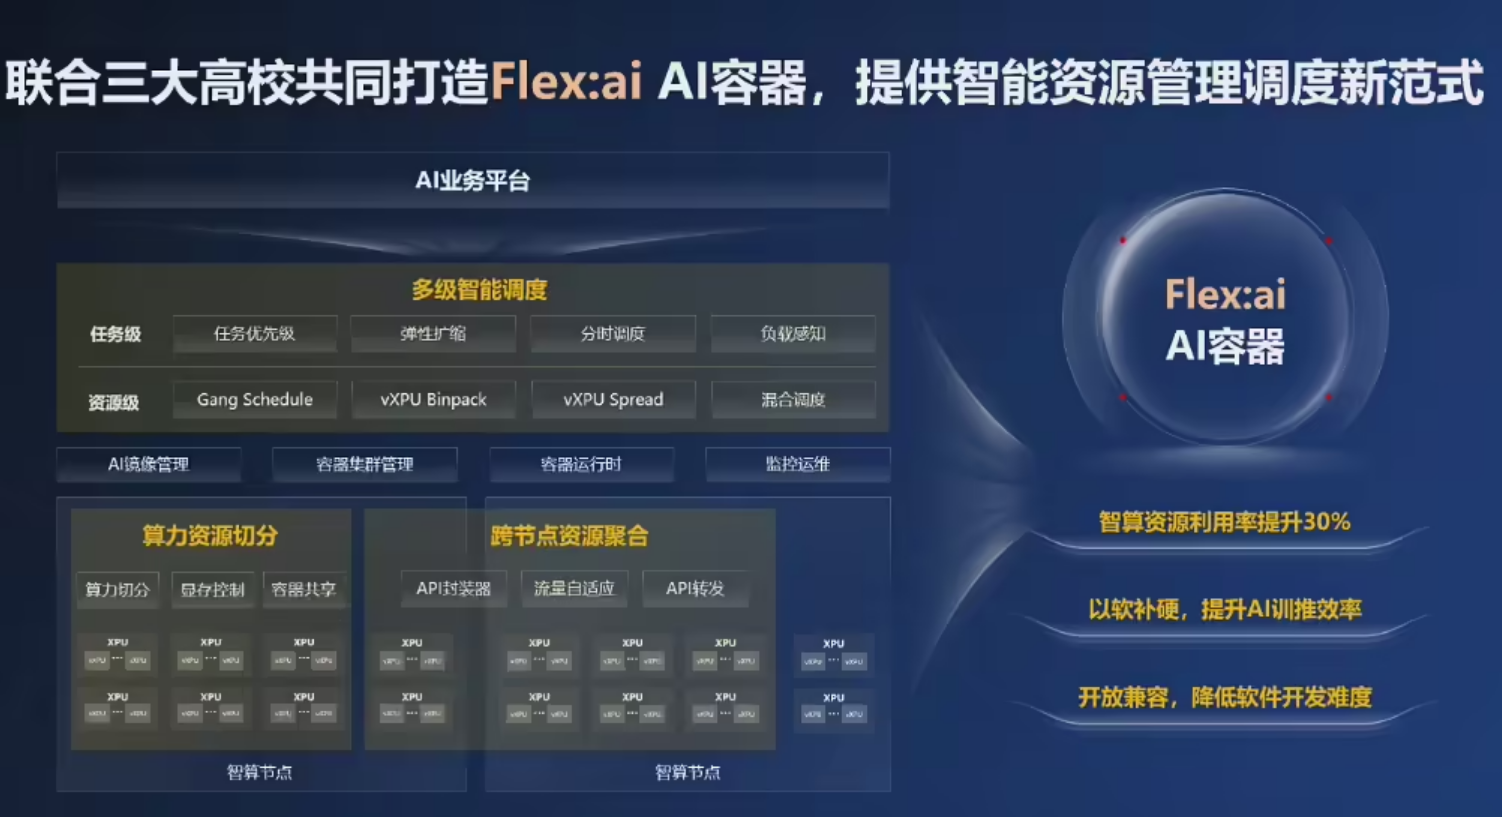
华为Flex:ai是华为在2025年11月21日发布的AI容器软件,基于Kubernetes(开源容器编排平台)构建。它解决的核心问题是AI算力资源浪费。行业数据显示,全球AI训练集群平均GPU利用率仅为34%。部分中国智算中心甚至低于这一水平。这意味着每投入1亿元建设算力,可能有近7000万元在空转。该工具通过算力切分、跨节点聚合、智能调度三大能力,宣称可将利用率提升至70%。但开源初期文档不完整、社区未成熟,实际部署门槛可能高于宣传。
从算力浪费到软件定义算力
传统AI任务往往独占整张GPU或NPU,但约60%的AI任务并不需要整卡。小模型训练、推理请求、微调任务只消耗少量算力。独占模式导致大量资源闲置。华为Flex:ai采用软件定义算力思路,将物理算力卡切分为多个虚拟单元。最小粒度10%,一张卡可同时跑多个任务。华为实测数据显示,典型多租户场景下,集群整体利用率可从35%提升至60%以上。这相当于用原有硬件实现近70%的性能增益。但这一数据来自华为内部测试,第三方独立验证尚缺。
开源与产学研结合的真实意图
该工具在发布当天即开源至魔擎社区。华为与上海交通大学、西安交通大学、厦门大学联合研发。上海交大负责XPU池化框架,厦大攻克跨节点拉远虚拟化,西交大主导Hi Scheduler调度器。开源策略降低了企业使用门槛,也试图建立行业标准。但产学研结合模式存在风险。高校团队的技术持续性依赖项目经费和人员稳定。若后续投入不足,开源社区可能陷入停滞。目前尚无公开数据表明社区贡献者数量或代码活跃度。
华为Flex:ai主要功能的实际表现
该工具宣称四大核心功能:算力切分、跨节点聚合、智能调度、异构管理。以下逐条拆解实际表现。
10%粒度切分:单卡多任务的真实收益
切分粒度10%意味着单张A100可划分为10个虚拟单元。每个单元独立运行一个AI任务。华为与上海交大联合研发弹性资源隔离技术,确保任务间互不干扰。官方数据显示,细粒度切分使算力平均利用率提升30%。虚拟化性能损耗控制在5%以内。但实际场景中,不同任务对显存、带宽、算力的需求差异极大。10%固定粒度可能无法适配所有负载。例如,某些推理任务需要20%算力但只需少量显存,固定切分会造成新的浪费。目前尚无公开数据说明动态调整机制的实际效果。
跨节点聚合:通用服务器如何借力XPU
拉远虚拟化技术将集群内各节点的空闲XPU聚合为共享算力池。厦门大学设计的上下文分离技术打破了XPU服务范围限制。公开数据称,该技术使集群外部碎片减少74%,高优作业吞吐量提升67%。这意味着没有GPU的通用服务器可通过高速网络,将AI负载转发到远端算力卡执行。但跨节点通信依赖网络延迟和带宽。对于大模型分布式训练,通信开销可能抵消聚合收益。华为未公开在低带宽或高延迟网络下的性能数据。
Hi Scheduler调度器的三类策略
Hi Scheduler由华为与西安交大共同构建。它采用三类策略:高优先级抢占、闲时分时调度、数据驱动触发。高优先级任务可直接夺取资源,保障关键负载。闲时调度让低优先级任务在夜间运行。数据驱动触发在增量数据达到阈值时自动启动训练。官方宣称在负载频繁波动下也能平稳运行。但复杂负载下的稳定性缺乏第三方验证。抢占策略可能导致低优先级任务频繁中断,实际吞吐量未必提升。目前尚无公开的调度延迟或任务失败率数据。
异构算力统一管理:中立还是绑定?
该工具支持英伟达GPU、华为昇腾NPU等异构芯片。通过“物理层-虚拟层-应用层”三层池化架构,打破厂商壁垒。华为强调对第三方芯片保持中立。但昇腾NPU与华为自有生态深度绑定。在昇腾上可能获得更优的软硬件协同优化。英伟达GPU的支持程度取决于CUDA兼容性。如果华为在调度器或驱动层对昇腾倾斜,中立性就会打折扣。目前尚无独立测试对比不同芯片在Flex:ai下的性能差异。
华为Flex:ai怎么用起来
该工具基于Kubernetes构建,部署和使用需要一定的容器技术基础。
环境准备与Kubernetes部署要点
部署前需准备Kubernetes集群(版本未明确要求)、高速网络、GPU/NPU驱动。源码从魔擎社区获取。部署步骤包括:下载源码或部署包、通过CRD(自定义资源定义,用于扩展Kubernetes对GPU/NPU的细粒度管理)、配置Hi Scheduler策略、设置监控体系。官方文档未详细说明网络带宽要求或驱动版本兼容性。对于没有K8s经验的中小团队,环境准备可能耗时数天。
从镜像打包到任务提交的完整流程
用户需将AI应用打包为容器镜像。镜像内包含模型代码、依赖库、运行环境。然后通过API或UI提交虚拟算力单元申请。系统自动切分资源并调度任务。该工具支持TensorFlow、PyTorch等主流框架。应用无需修改代码即可运行。但镜像打包本身需要Docker或类似工具的知识。如果应用依赖特定GPU驱动或CUDA版本,镜像构建可能遇到兼容性问题。官方未提供预置镜像模板。
华为Flex:ai和同类差在哪
与英伟达Run:ai相比,该工具有两大差异:拉远虚拟化和智能调度。与原生Kubernetes调度器相比,改进明显但生态不足。
与Run:ai的两大差异:拉远虚拟化与智能调度
Run:ai主要服务于英伟达GPU生态,切分粒度为25%静态分片。华为Flex:ai支持10%动态切分,且支持昇腾NPU。拉远虚拟化是Run:ai不具备的能力,可聚合跨节点空闲XPU。智能调度器Hi Scheduler自动感知负载并全局优化。华为官方认为这两点构成独特优势。但Run:ai在英伟达GPU上的性能损耗更低(<3% vs Flex:ai的<5%)。Run:ai的商业支持更成熟,文档和社区更完善。
相比原生Kubernetes调度器的改进
原生K8s对GPU/NPU感知粗糙,调度粒度粗、回收延迟高、跨节点协同弱。Flex:ai通过CRD扩展细粒度管理,支持0.1卡起配。调度器考虑任务SLA、数据亲和性、能耗成本。故障定位时间较传统模式缩短50%(官方测试数据)。但原生K8s生态庞大,插件丰富。Flex:ai作为新项目,与现有监控、日志、CI/CD工具的集成尚不成熟。用户可能需要自行开发适配层。
华为Flex:ai应用场景
该工具适用于模型训练、推理、多租户共享、边缘计算等场景。
小模型训练与并发推理的实测场景
小模型任务独占整卡导致浪费。例如,一个参数量不足1亿的文本分类模型,训练时只用到GPU算力的15%。Flex:ai切分后,同一张卡可同时承载多个推理请求或训练任务。某高校AI实验室通过该工具将GPU利用率从40%提升至70%。支持更多学生同时进行模型训练。但并发推理场景下,任务间可能争抢显存带宽。官方未提供高并发下的延迟数据。
大模型分布式训练与跨节点聚合
大模型单机算力不足时,需要多卡并行。Flex:ai可聚合空闲XPU提供支撑。瑞金医院案例中,多模态病理大模型RuiPath仅用16张昇腾910B完成训练。该模型基于103万张病理切片,覆盖19个癌种。官方称XPU资源可用度从40%提升至70%。但分布式训练对网络延迟极其敏感。跨节点聚合引入额外通信开销。如果节点间网络带宽低于100Gbps,训练效率可能大幅下降。华为未公开该案例的网络配置细节。
华为Flex:ai的优点和缺点
优点集中在利用率提升和成本节省。缺点包括性能损耗和生态不成熟。
利用率提升带来的直接成本节省
利用率从35%提升至60%以上,相当于硬件投资减半。一个拥有100张A100的集群,原有效算力约35张卡。提升后等效约60张卡。按A100单价约8万元计算,节省硬件成本约200万元。对于中小企业,开源免费进一步降低门槛。测算显示,采用该工具后企业硬件成本可降低30%以上。但这一测算基于华为官方利用率数据,实际收益取决于工作负载类型和集群规模。
性能损耗与生态锁定的隐忧
虚拟化性能损耗控制在5%以内,官方宣称相对收益可忽略。但5%的损耗在延迟敏感型推理任务中可能放大。例如,实时语音识别要求端到端延迟低于100毫秒,额外5%的损耗可能造成体验下降。开源初期文档不完整、社区支持不足。魔擎社区日均访问量超1.6万,但贡献者数量和代码审查质量未知。如果华为后续减少投入,开源项目可能沦为“僵尸仓库”。
华为Flex:ai版本变化
从2025年11月发布至2026年4月,公开信息有限。
从发布到开源的迭代节奏
2025年11月21日,该工具正式发布并同步开源至魔擎社区。初始版本包含算力切分、跨节点聚合、Hi Scheduler调度器。此后五个月内,无重大功能更新的公开报道。版本号、更新日志、路线图均未公开。这可能表明项目处于早期阶段,或华为未积极维护社区。对于企业用户,缺乏明确迭代计划会增加采用风险。
性价比分析:华为Flex:ai是否值得投入
开源免费与商业方案的成本差异显著。
开源免费与商业方案的算力账
Run:ai采用商业授权,按GPU数量或订阅收费。具体价格未公开,但行业估计每GPU年费在数千美元。Flex:ai开源免费,企业只需承担部署和运维成本。对于拥有50张GPU的中小企业,使用Run:ai年费可能超过10万美元。改用Flex:ai可节省这笔费用。同时利用率提升带来的硬件节省约100万元(按50张A100计算)。但开源软件需要内部技术团队支持。如果团队缺乏K8s经验,招聘或培训成本可能抵消部分节省。
学习曲线:从Kubernetes到Flex:ai的上手难度
已有容器经验的团队上手较快,但文档和社区是短板。
已有容器经验的团队需要多久适配
该工具基于Kubernetes构建,熟悉K8s的团队可在数周内完成部署。核心工作包括:理解CRD定义、配置调度策略、测试任务提交。官方提供技术文档和部署指南,但缺乏系统培训材料。没有官方认证课程或视频教程。团队需要自行摸索最佳实践。对于只有基础Docker经验的团队,学习周期可能延长至1-2个月。
从文档到社区:开源初期的支持短板
魔擎社区提供源码和基础文档,但文档覆盖不全。例如,网络配置、故障排查、性能调优等章节缺失。社区论坛活跃度未知,问题响应速度无公开数据。用户遇到问题可能只能自行阅读源码。华为未承诺商业支持服务。对于关键业务场景,缺乏官方支持意味着风险自担。