绘想是什么:百度 MuseSteamer 驱动的图生视频平台
静态图片只能看,不能动。想让照片里的人物开口说话、让风景动起来,过去你得会剪辑、会配音、会调运镜。绘想(百度推出的 AI 视频创作平台)解决了这个具体问题:上传一张图,写一句话,它就能生成带声音、带运镜的短视频。
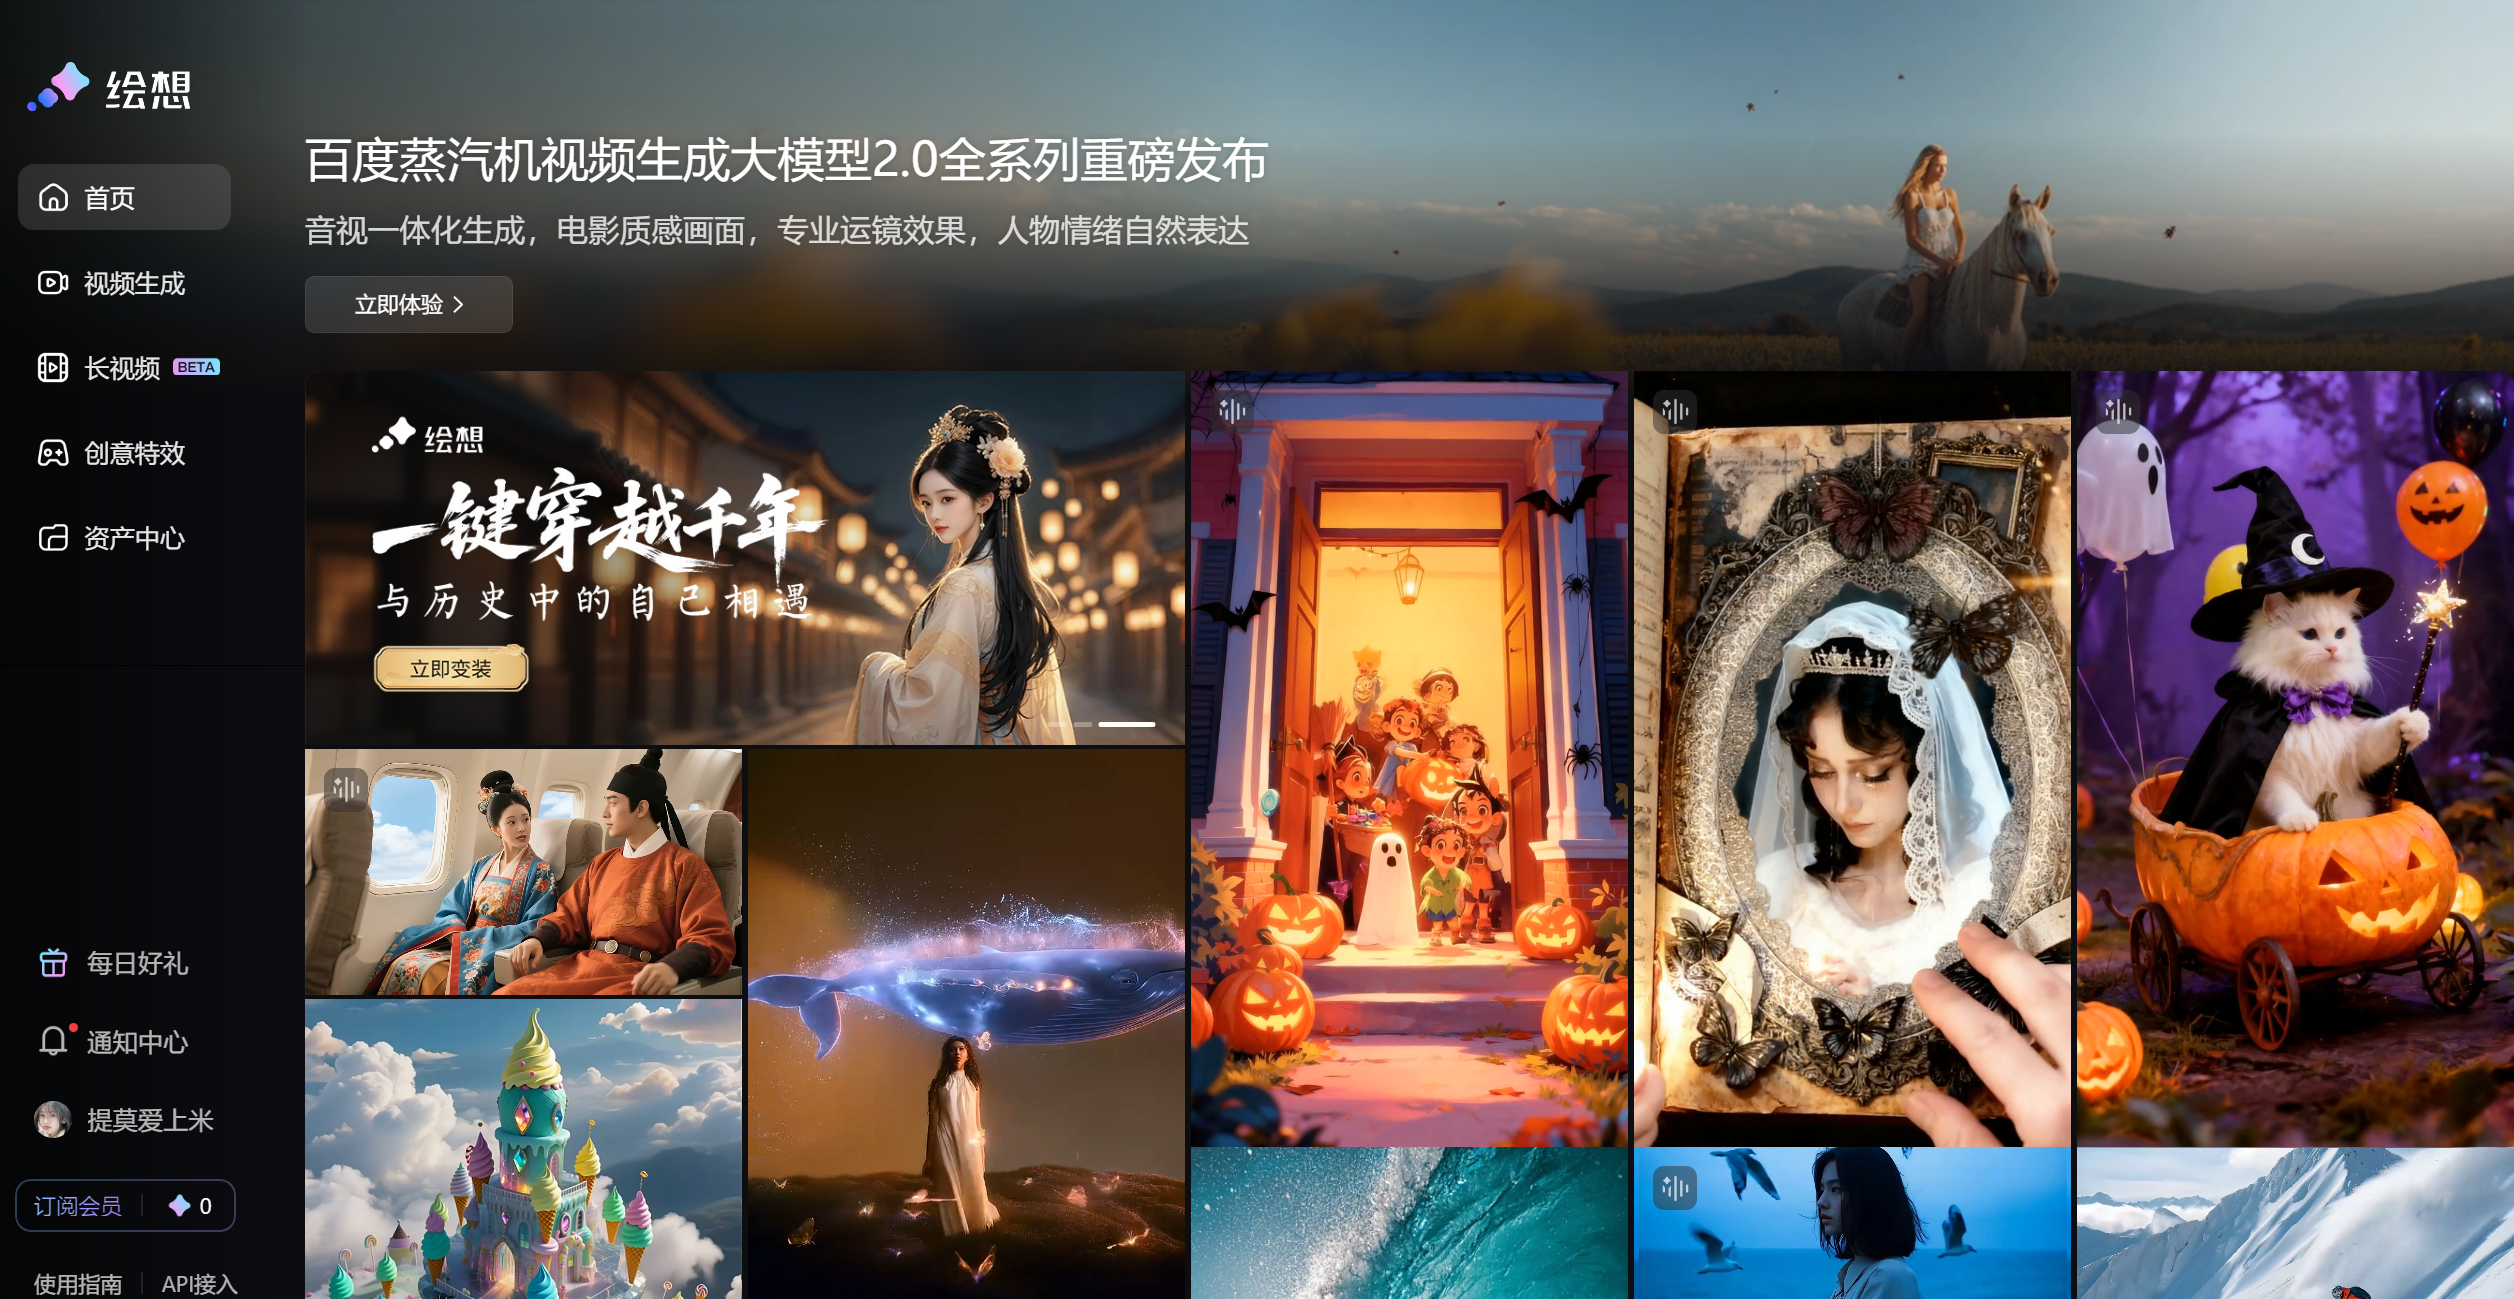
该平台的核心卖点是音视频一体化生成。画面、音效、台词一次完成,不用再单独配音。背后的技术底座是百度自研的 MuseSteamer 模型。2025 年 5 月,这个模型在 VBench I2V 榜单上以 89.38% 的总分登顶全球第一。VBench 是视频生成模型的权威评测基准,I2V 指图生视频任务。
适用人群分两类。一类是短剧、广告从业者,需要低成本快速产出素材。另一类是普通用户,想把生活照片变成动态短片。对他们来说,动态视频生成的门槛被降到了上传一张图的程度。截至 2025 年 11 月,平台处于限时免费公测阶段,没有积分和次数限制。
从营销工具到全民创作:绘想的诞生逻辑
这款工具最初不是给普通用户做的。百度商业团队为了满足短剧投放和广告创意需求,开发了 MuseSteamer 模型。传统富媒体广告素材制作门槛高、成本高,团队想用 AI 把这件事简化。
据百度副总裁陈一凡在 2025 年 7 月 AI DAY 上的介绍,模型先解决了 B 端营销场景的问题。随后团队发现,这套技术对普通用户也有吸引力。于是平台向 C 端开放,进入限时免费公测。
这个路径和很多 AI 工具相反。多数产品先做 C 端再找商业场景,这款工具是先有商业需求,再开放给个人。好处是功能更务实,少了很多花哨但没用的设计。
MuseSteamer 模型:VBench 榜首的技术底座
据百度官方介绍,MuseSteamer 是全球首个支持中文音视频一体化生成的视频模型。它采用了「场景颗粒度拆解」训练方法。简单说,就是把视频按「生活服务、电商展示、知识科普」等场景分开训练。
这样做的结果是,电商展示视频能自动匹配镜头推拉与解说节奏。知识科普视频会更注重清晰表达。模型对中文语音细节和发音口型有较高拟合能力。
VBench I2V 得分 89.38% 是一个可查的公开数据。这个分数代表模型在图生视频任务上的综合表现,包括动作连贯性、主体一致性、画面表现力等维度。不过分数只能说明测试时的表现,实际生成效果还受图片质量、提示词写法影响。
绘想的核心能力:音视频一体化生成
多数 AI 视频工具只生成画面,声音要后期加。绘想的不同点在于,它能同步生成画面、音效和人物台词。这个能力来自 MuseSteamer 模型的音视频一体化设计。
传统流程是:先生成无声视频,再用配音工具加声音,最后对齐口型。三步走,每一步都可能出错。它把三步合成一步。你上传图片,输入描述,系统直接输出带声音的成片。
其他功能如镜头控制、灵感推荐、创意特效也有,但不是核心。下面重点展开音视频一体化,其他功能简要提及。
声画同步:画面、音效、台词一次生成
工作流程很简单。你上传一张图片,在描述框里写明画面内容、音效要求、人物台词。系统会同时生成这三部分。
比如你上传一张咖啡馆照片,写「镜头缓缓推进,背景有咖啡机声音,画面左侧的人说:欢迎光临」。生成结果里,画面会动,咖啡机声音会出现,人物口型会匹配台词。
台词字数有建议范围。5 秒视频推荐 15-20 字,10 秒视频推荐 25-30 字。超过这个范围,口型同步可能变差。明确指定说话角色很重要,比如写「画面左侧的人说」,不要只写「有人说」。
这个功能对短剧创作者尤其有用。以前做一段对话戏,要分别处理画面、配音、字幕。现在一次生成,节省的时间很可观。
多人物同屏对话:口型与情感自动匹配
两个人物同屏对话是绘想的特色功能。你上传一张有两个人物的图片,分别指定两人的台词。系统会自动生成口型同步,并尝试匹配情感表达。
实测中,这个功能表现不错。人物说话时嘴部动作自然,不会出现「配音和嘴型对不上」的尴尬。情感表达方面,系统会根据台词内容调整语气和表情,但精细度有限。
使用时要明确区分说话角色。比如写「左边穿红衣的人说:你好。右边戴帽子的人说:好久不见」。不要混在一起写。
这个功能目前只支持两个人物。更多人物的同屏对话还没有开放。
其他功能速览:镜头控制、灵感推荐、创意特效
镜头控制支持多种运镜手法。镜头推进、拉远、环绕都可以通过提示词实现。比如写「低角度拍摄,镜头缓缓拉近」,系统会模拟对应的镜头运动。
灵感推荐是一个模板库。平台根据用户素材智能推荐创作方案,支持一键生成同款视频。新手可以用这个功能快速上手。
创意特效提供「毛绒世界」「古风换装」「剪纸世界」等预设效果。上传照片后选择特效,照片会变成对应风格。这个功能偏娱乐,适合社交媒体内容。
绘想从零开始怎么用:注册到生成视频的完整流程
操作门槛不高,AI 视频创作新手也能直接上手。整个流程分四步:注册登录、上传图片、输入描述、生成视频。下面逐步说明。
注册与登录:百度账号一键接入
访问官网 https://huixiang.baidu.com/。点击右上角【登录】。支持百度 APP 扫码、手机号验证码、账号密码三种方式。
国内网络直接访问,不需要特殊上网环境。基于 Web 平台,主流配置电脑就能用,手机浏览器也可以。
上传图片与输入描述:格式、大小、提示词要点
登录后,点击左侧【视频生成】进入创作页面。点击添加图片,支持 JPEG、JPG、PNG、WEBP 四种格式。尺寸不小于 300px,文件不超过 10MB。
描述要具体。包括场景、动作、镜头运动。示例:「低角度拍摄,镜头缓缓拉近。一辆经典的白色轿车在乡间小路上行驶,阳光洒落在车身上」。
不要只写「一个人走路」。要写「一个穿红色外套的女人在公园里快步走,镜头跟随,背景有鸟叫声」。细节越多,生成结果越接近预期。
选择模型版本:Turbo、Lite、Pro、有声版怎么选
平台提供多个模型版本。选择依据是你的需求。
| 版本 | 分辨率 | 特点 | 适合人群 |
|---|---|---|---|
| Turbo | 720p | 擅长人物、动漫,动作一致性优秀 | 大部分创作者 |
| Lite | 720p | 生成速度约 30 秒,性价比高 | 追求效率的用户 |
| Pro | 1080p | 电影级画质和运镜 | 专业创作者 |
| 有声版 | 各清晰度 | 支持音效和台词一体化生成 | 需要同期声的用户 |
如果你只需要画面,选 Turbo 或 Lite。如果需要声音,选有声版。Pro 版画质最好,能产出接近 AI 生成电影质感的画面,但生成时间可能更长。
生成与调整:等待时间、镜头控制、重新生成
选好模型和时长(5 秒或 10 秒),点击【立即生成】。通常等待 1-3 分钟。
预览生成效果。不满意可以重新编辑描述,再次生成。镜头控制通过提示词实现,比如「镜头环绕」「镜头拉远」。
下载视频后可以用于社交媒体或广告投放。目前没有内置剪辑功能,需要后期处理的话得用其他工具。
绘想 vs 同类工具:图生视频怎么选
图生视频工具不少。绘想的定位很清晰:专注图生视频,突出音视频一体化。下面和两类工具对比。
与通用 AI 平台对比:专注图生视频的取舍
以智谱清言为例。智谱清言支持文生视频和图生视频,功能更全面。但生成速度较慢,据第三方对比测评需要 10 分钟以上。绘想通常 1-3 分钟完成。
专注带来的优势是效率。绘想不做文生视频,不做聊天,只做图生视频。资源集中,生成速度更快。
代价是功能单一。如果你需要文生视频,它帮不了你。如果你只需要图生视频,它比通用平台更顺手。
与其他图生视频工具对比:音视频一体化是分水岭
多数图生视频工具只生成画面。声音要后期加。绘想的有声版直接输出带声音的视频。
这个差异在短剧和广告场景里很关键。做一条 10 秒的广告片,传统流程要画面、配音、混音三步。绘想一步完成。
其他工具如阶跃视频、通义千问也支持图生视频,但音视频一体化能力没有公开数据可查。绘想在这个领域有先发优势。
绘想适合什么场景:从短剧广告到社交媒体
绘想不是万能的。它适合特定场景。下面列举三个典型场景,结合实测体验说明。
短剧和广告:低成本快速产出素材
短剧投放需要大量素材。传统制作成本高、周期长。现在几分钟内就能生成一段 10 秒的带声音视频。
实测中,用一张产品图生成广告素材,画面运镜自然,音效匹配。有第三方测评称单日视频产能可提升近百倍,实际效果取决于使用强度。
广告创意人员可以用它快速验证想法。先低成本生成几个版本,看哪个效果好,再决定是否投入精制。
社交媒体内容:让静态照片动起来
普通用户可以用绘想把生活照片变成动态视频。一张旅行照片,加上「镜头缓缓移动,风吹动树叶」的描述,就能生成一段适合发朋友圈或小红书的短片。
创意特效功能在这里很实用。「毛绒世界」把照片变成毛绒玩具风格,「古风换装」给人物换上古代服饰。这些效果在社交媒体上容易获得互动。
实测案例:一张 Labubu 玩具图片,通过绘想生成「森林里,阳光透过树叶洒落,镜头缓缓移动,Labubu 旋转跳跃」的视频。效果自然,适合分享。
教育与科普:动态演示提升理解
教育场景需要直观演示,静态图表或示意图都能变成动态视频。
比如一张细胞结构图,加上「镜头推进,标注各部分名称」的描述,就能生成一段教学短片。知识科普视频会自动匹配清晰的表达节奏。
这个场景目前使用的人不多,但潜力存在。在线课程和电子教材都可以用这种方式丰富内容。
绘想版本变化:最近 3-6 个月的功能更新
绘想更新速度较快。2025 年下半年有几个重要变化。
从 Turbo 到有声版:模型版本演进
2025 年 7 月 2 日,平台正式发布,开启限时免费公测。初始版本是 Turbo,720p 分辨率。
2025 年 9 月,有声版实测表现优异,支持多人物同屏对话,口型同步精准。这个版本把音视频一体化能力推到了可用水平。
Pro 版本提供 1080p 电影级画质,但具体发布时间没有公开数据。技术团队透露正在研发突破 30 秒长镜头生成。
长视频模式:突破 10 秒限制
2025 年 10 月,MuseSteamer 突破 AI 视频生成 10 秒时长限制。长视频模式提供 10-60 秒时长选择,续写可进一步延长,并支持交互式修改提示词。
这个更新对短剧创作者意义重大。以前只能生成 10 秒片段,现在可以生成更完整的叙事段落。
长视频模式的具体使用限制没有公开数据。生成时间可能更长,对图片和提示词的要求可能更高。
绘想在国内的可用性:访问、中文界面与支付
国内用户使用绘想没有障碍。访问、界面、支付都针对国内环境设计。
官网 https://huixiang.baidu.com/ 国内网络直接访问。界面全中文,提示词支持中文,对中文语音节奏和语境有深度适配。
截至 2025 年 11 月,平台处于限时免费公测阶段,没有付费入口。未来可能推出付费版本,但基础功能预计仍会保持免费。具体付费方案尚无公开数据。
登录用百度账号,账号体系和百度网盘、百度搜索相通。对国内用户来说,注册成本几乎为零。
绘想的音视频一体化生成目前还不能自定义人物音色。系统自动生成人声,你想换一个声音,得用其他语音克隆工具生成语音后再合成。这是它尚未完全解决的一个真实问题。