
Cradle.bio 是什么:先看最大局限
Cradle.bio 是一个面向生物研发团队的 AI 蛋白质设计平台。新用户试用前最该知道一件事:这个平台不提供免费公开试用。想用,得先联系销售或受邀访问。
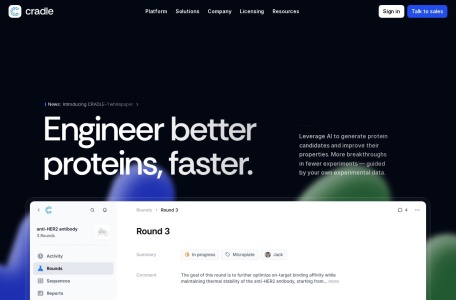
该工具由 Cradle 公司推出,专注蛋白质工程。它的核心能力不是通用聊天或图像生成,而是基于客户自有实验数据训练定制模型。官网明确写着:客户序列和数据保持私有,仅受邀者可访问。这意味着没有邀请,连界面都看不到。
对普通个人用户来说,这道门槛很高。没有企业邮箱、没有研发项目,基本无法体验。所以它不是一个“注册就能玩”的工具。
平台定位:生成式AI而非通用工具
Cradle.bio 的定位是生成式 AI,但只服务于蛋白质设计。它的模型在数十亿个蛋白质序列及自有实验室数据上训练。生成结果不是文本或图片,而是蛋白质候选序列。
与 ChatGPT 这类通用工具不同,该平台不回答百科问题,也不写代码。它只做一件事:根据输入条件生成可能有效的蛋白质序列,并预测性能。
这种专注带来效率,但也限制了用户群。没有蛋白质工程背景的人,拿到序列也难判断好坏。
核心用户:生物学家与科研团队
典型用户画像包括:
- 生物制药公司的蛋白质工程团队
- 工业生物技术研发部门(如诺维信)
- 学术实验室研究酶、抗体、疫苗的课题组
这些团队有共同特点:拥有自己的实验数据,需要快速迭代候选分子。平台的价值在于用这些数据训练定制模型,减少试错次数。
Cradle.bio 主要功能的实际表现
官方展示的功能围绕四个环节:生成候选、预测评分、多属性优化、迭代训练。每个环节都有具体数据支撑。
候选生成与性能评分
每个生成的蛋白质序列附带一个预测性能分数。这个分数帮助研究人员快速筛选,不必全部送去湿实验室验证。
官网没有公开评分算法的具体指标。但案例显示,在治疗性多肽工程中,成功率 50%,比先前工作快 5 倍。这个“快 5 倍”指的是达到同等成功率所需的实验轮次或时间。
分数不是绝对保证。它只是模型基于训练数据的预测,最终仍需实验确认。
多属性单轮优化
传统蛋白质工程通常一次只优化一个属性,比如只提高热稳定性。Cradle.bio 宣称能在单轮中处理多个属性和优化任务。
例如同时优化结合亲和力、特异性、表达量。官网原话是“engineered to handle multiple properties and optimization tasks in a single round”。
这对研发团队有实际意义:减少实验轮次,缩短周期。但多属性优化也意味着模型需要更多训练数据,否则预测精度可能下降。
实验数据迭代训练
平台随每轮实验学习,提供更优变体。流程是:用户上传湿实验室结果,模型重新训练,下一轮生成改进候选。
官网称“dramatically cutting your time-to-market”。具体缩短多少?案例中疫苗热稳定性优化比理性设计快 7 倍。
这个模式的前提是用户持续提供高质量实验数据。数据越少,模型提升越慢。
Cradle.bio 从零开始怎么用
使用流程分五步:注册、熟悉界面、选择项目、利用 AI 建议、分析结果并验证。但第一步就有门槛。
注册与访问限制
平台仅受邀者可访问。官网没有开放注册按钮。想获得访问权限,需联系销售或通过官网提交申请。
申请后是否批准、审批周期多长,官网未公开。有报道称 2023 年时需申请加入内测名单。目前是否仍为内测状态,暂无公开信息。
设计流程:从候选到验证
假设已获得访问权限,操作流程如下:
- 明确需求:确定目标蛋白质类型和要优化的属性。
- 利用 AI 建议:选择改进目标,点击生成候选。
- 可视化分析:在平台内查看候选序列及预测分数。
- 湿实验室验证:将高分候选送去实验。
- 反馈训练:上传实验结果,训练定制模型。
这个循环重复进行,每轮候选质量理论上会提升。
Cradle.bio 和竞品对比什么
对比对象分两类:通用 AI 工具和传统理性设计方法。差异明显。
与通用AI工具的差异
通用 AI 工具(如 ChatGPT)不针对蛋白质序列优化。它们没有蛋白质结构或功能预测能力。
Cradle.bio 提供领域专用模型,训练数据是蛋白质序列和实验数据。两者输入输出完全不同。
| 比较维度 | Cradle.bio | 通用 AI 工具 |
|---|---|---|
| 输出类型 | 蛋白质序列 | 文本、代码、图像 |
| 训练数据 | 蛋白质序列+自有实验数据 | 公开文本、图像 |
| 性能预测 | 有评分 | 无 |
| 数据隐私 | 客户数据私有 | 通常用于训练公共模型 |
与传统理性设计对比
理性设计依赖专家经验和物理化学规则,一次改一个位点。Cradle.bio 用机器学习生成大量候选。
案例:金黄色葡萄球菌疫苗热稳定性,单轮提升 2.5°C。官网称比理性设计快 7 倍。
这个“快 7 倍”指达到相同提升幅度所需的时间或实验次数。具体对比基准未公开。
Cradle.bio 适合什么人用
适合有实验数据、有预算、需要快速迭代的研发团队。具体场景包括多肽、疫苗、酶、抗体。
治疗性多肽工程
案例显示成功率 50%,比先前工作快 5 倍。多肽药物研发中,序列优化是关键步骤。该平台能生成大量候选并预测活性。
疫苗稳定性优化
金黄色葡萄球菌疫苗热稳定性单轮提升 2.5°C。疫苗对温度敏感,稳定性提升可降低冷链成本。
酶与抗体设计
平台支持多种蛋白质类型,覆盖稳定性、表达、活性、结合亲和力、特异性等特性。酶设计常用于工业催化,抗体设计用于药物开发。
Cradle.bio 的数据隐私与安全
隐私是平台重点强调的部分。客户序列和数据保持私有,不会用于训练他人模型。
数据所有权与知识产权
客户保留全部知识产权,无版税。平台只收软件订阅费。这意味着客户用平台生成的蛋白质序列,专利和商业权利归客户。
安全措施与访问控制
官网称采用“银行级安全措施”。仅受邀者可访问。具体加密标准、认证协议未公开。
谁完全不该用 Cradle.bio
三类人群不适合:没有自有实验数据的团队、预算有限的个人研究者、需要免费工具的用户。
无实验数据的小团队
平台依赖客户自有数据训练模型。没有数据,模型无法定制,效果受限。通用 AI 工具或开源蛋白质设计软件可能更合适。
预算有限的个人研究者
平台为订阅制,无免费公开版本。价格未公开,但面向企业客户,个人研究者通常难以承担。
替代方案:开源工具如 Rosetta、ColabFold,或通用 AI 工具做初步序列分析。